Badania
Przyszłość, która już się dzieje
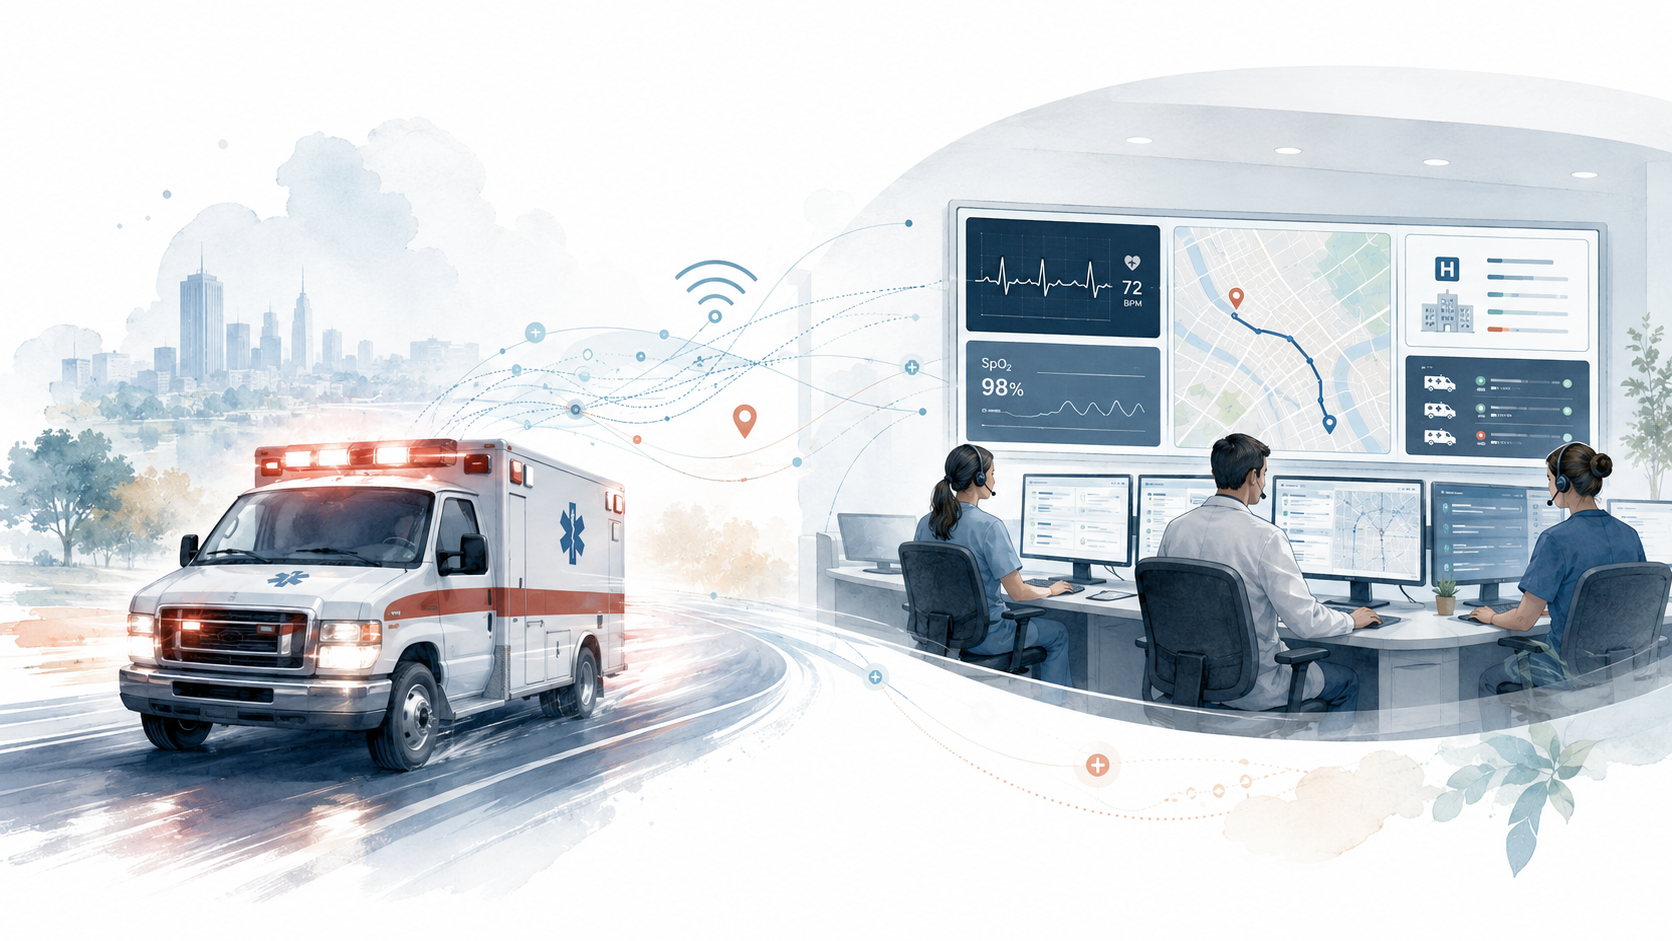
Wyobraźmy sobie osobę, u której podczas samotnego pobytu w domu występuje ostry zespół wieńcowy i która nosi urządzenie stale monitorujące parametry życiowe. Gdy urządzenie wykrywa krytyczne zmiany, takie jak nieprawidłowy elektrokardiogram lub spadek poziomu tlenu, automatycznie uruchamia procedurę ratunkową. W ciągu kilku sekund system lokalizuje i wysyła najbliższą dostępną karetkę, uwzględniając w czasie rzeczywistym ruch drogowy oraz możliwości szpitali.
Podczas transportu urządzenie nieprzerwanie przekazuje istotne dane pacjenta, umożliwiając bieżące dostosowywanie decyzji medycznych i logistycznych. Jeśli stan pacjenta się pogarsza, szpital otrzymuje powiadomienie pozwalające przygotować oddział intensywnej terapii. Po przyjeździe modele predykcyjne wspierają podejmowanie decyzji, pomagając osiągnąć najlepszy możliwy wynik przy jak najefektywniejszym wykorzystaniu zasobów ochrony zdrowia.
Nasza misja i wizja
Naszym długoterminowym celem jest stworzenie ram podejmowania decyzji w ochronie zdrowia, które będą wspierać lepsze decyzje kliniczne i w zakresie zdrowia publicznego na poziomie jednostki i populacji poprzez połączenie biostatystyki, cyfrowych technologii zdrowotnych i badań operacyjnych.
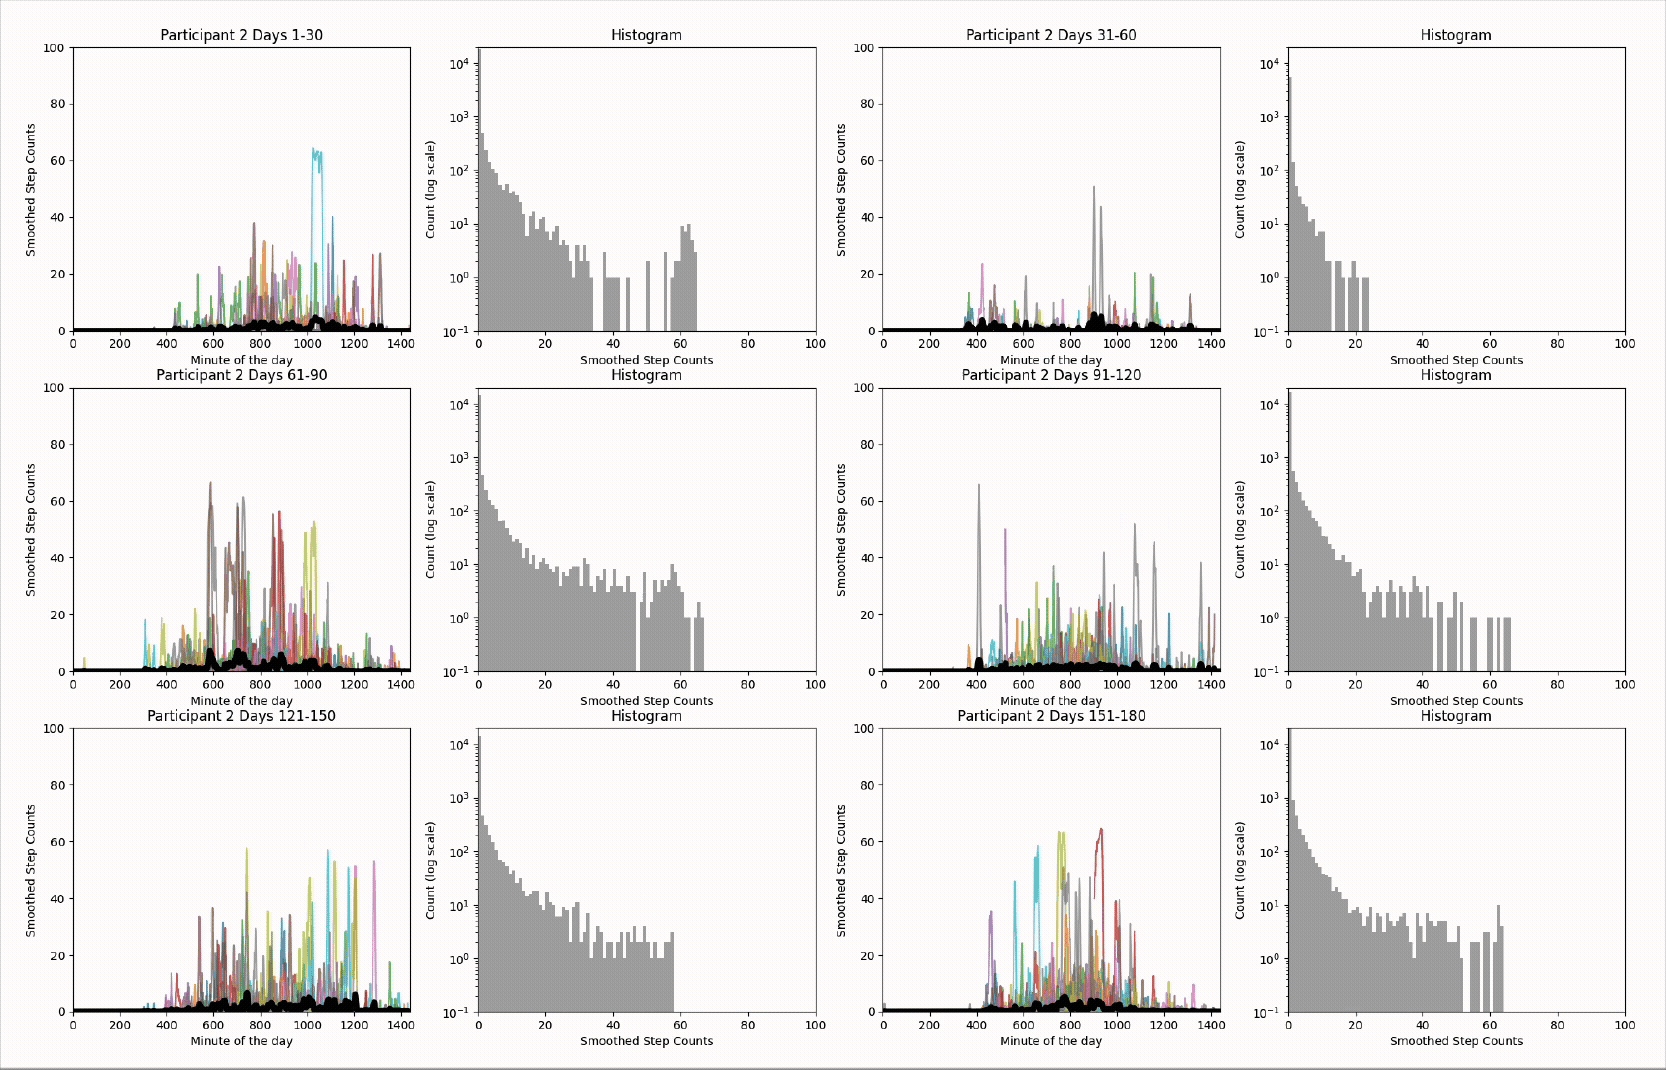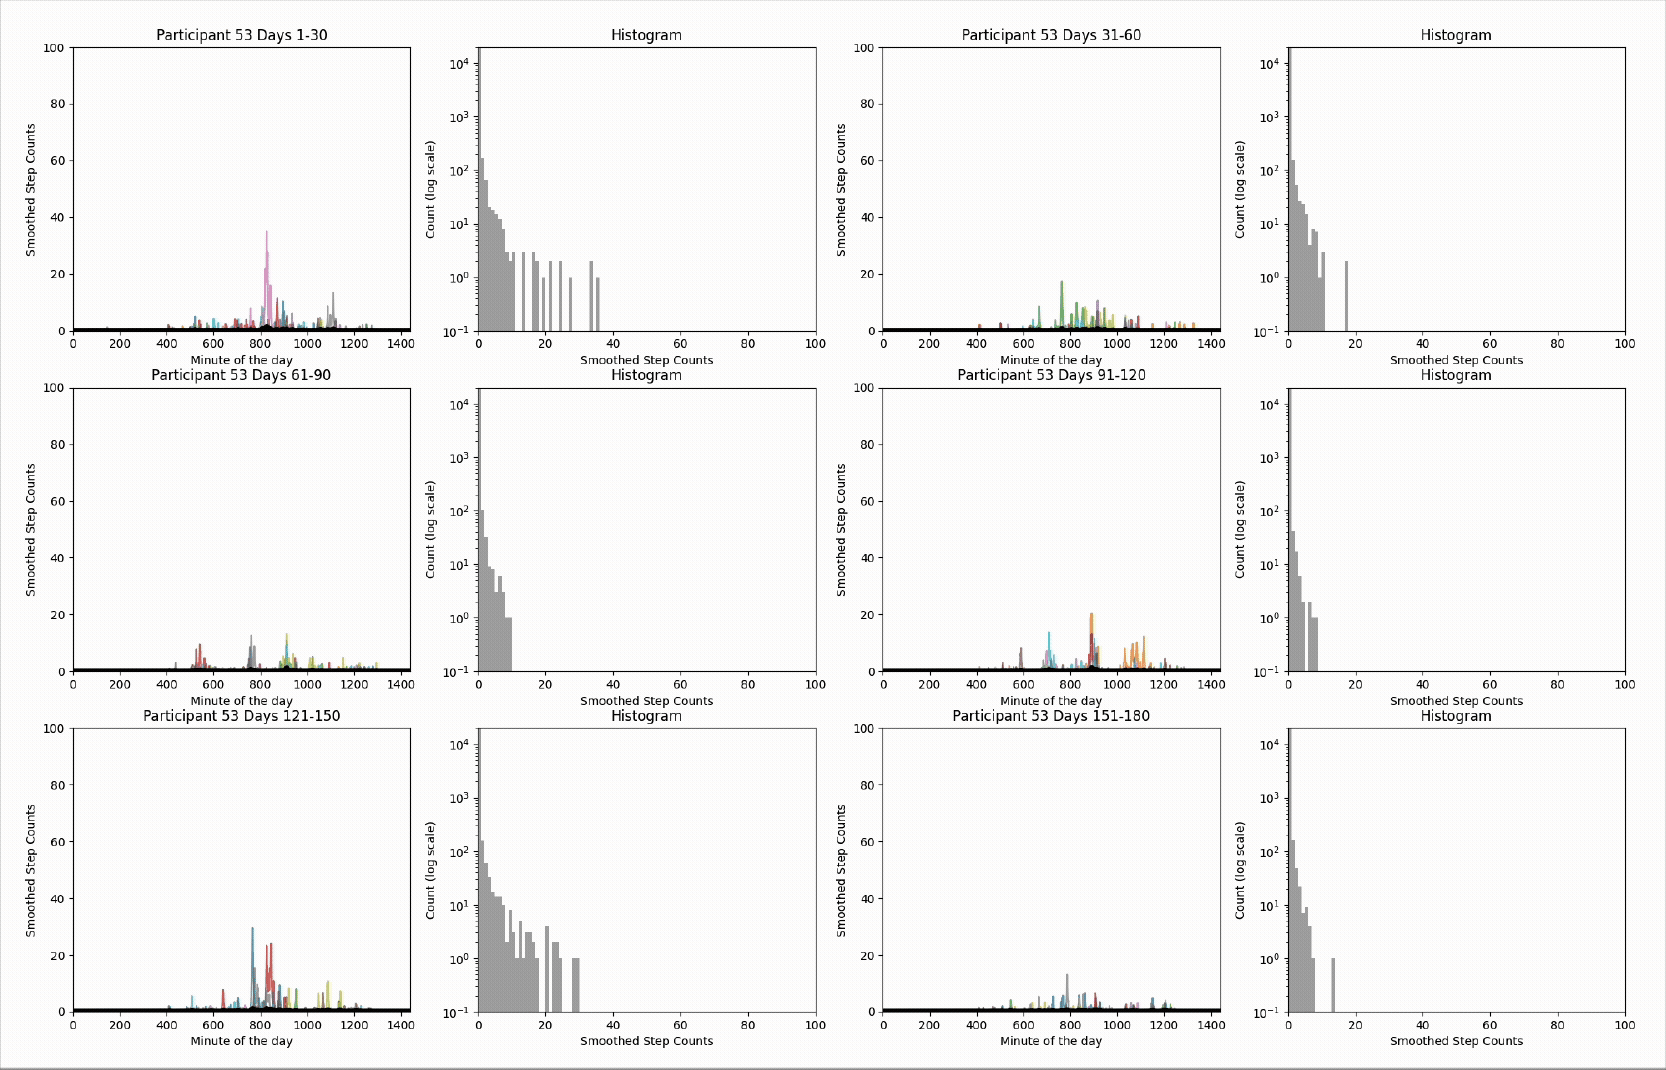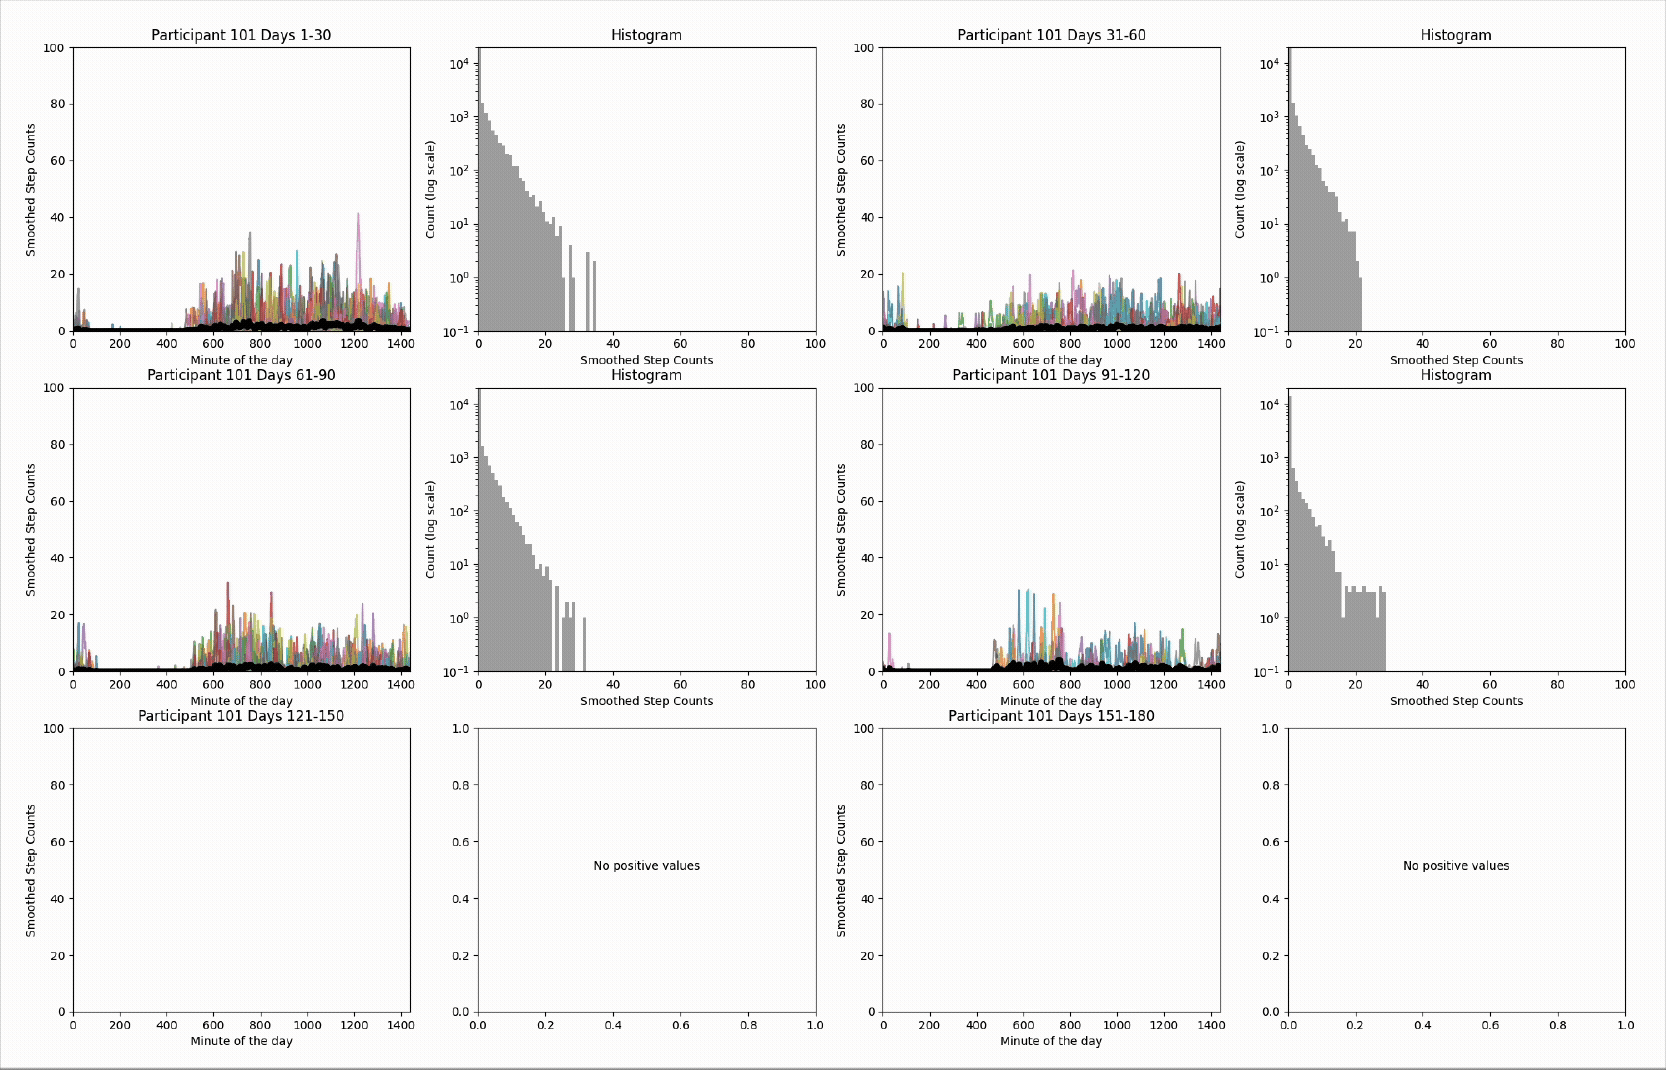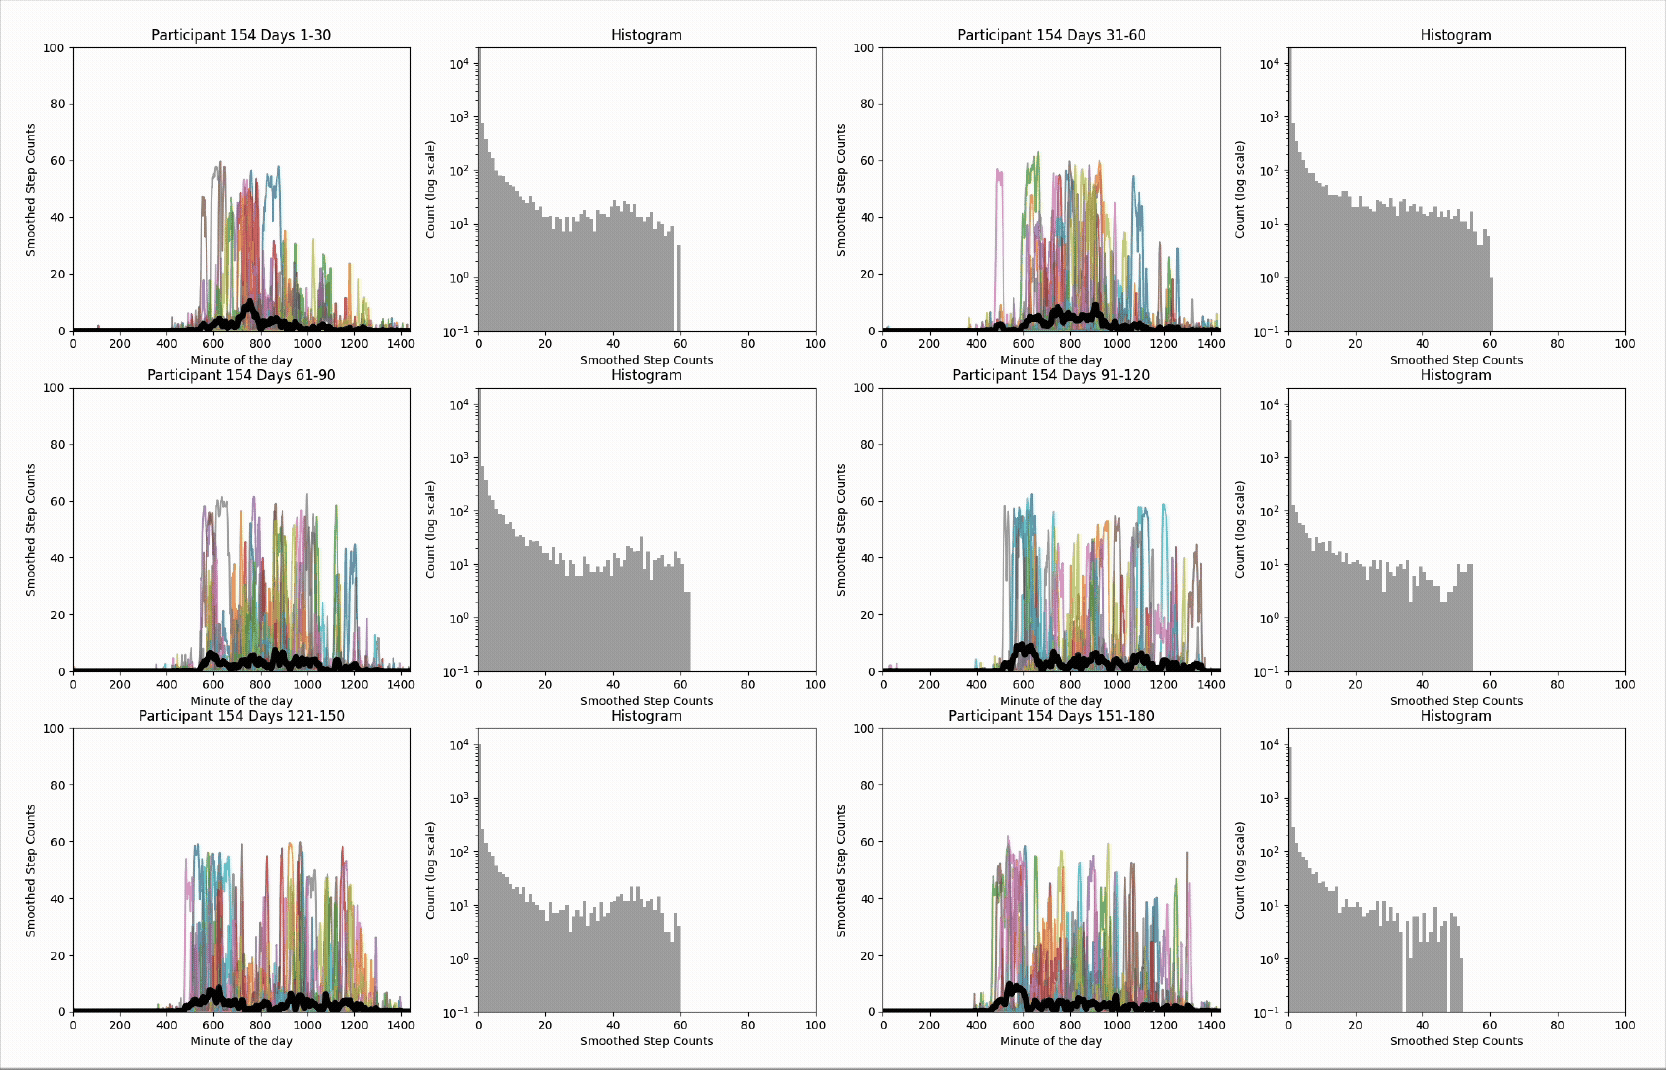
Obecnie opracowujemy metody statystyczne i metody sztucznej inteligencji dla złożonych problemów klinicznych obejmujących ciągłe, wysokoczęstotliwościowe dane o zdrowiu dostępne w czasie rzeczywistym. Chcemy, aby metody te nie tylko odpowiadały na istniejące pytania medyczne, ale także pomagały identyfikować pytania najważniejsze. Jaka dieta jest najlepsza dla konkretnej osoby? Ile aktywności fizycznej potrzeba, by wspierać zdrowe starzenie się i długowieczność? Jak powinny zmieniać się te zalecenia zależnie od profilu klinicznego, biologii, środowiska i stylu życia danej osoby?
Aby odpowiedzieć na te pytania, łączymy nowoczesne metody statystycznej AI do wnioskowania przyczynowego, analizy przeżycia, kwantyfikacji niepewności i modelowania generatywnego z efektami losowymi, rozwijając uczenie statystyczne dla nieeuklidesowych obiektów losowych. Staranny projekt badań i skalowalność obliczeniowa są kluczowe dla tej wizji. Naszym celem są metody matematycznie rygorystyczne, a jednocześnie wydajne obliczeniowo w skali populacji, przeznaczone do zasobów biomedycznych takich jak UK Biobank, All of Us Research Program, Human Phenotype Project i NHANES.
Choć wiele metod publikowanych w czołowych czasopismach metodologicznych cechuje rygor matematyczny i poprawność techniczna, nie zawsze powstają one z myślą o złożoności i hipotezach związanych z rzeczywistymi danymi klinicznymi. Dlatego nasze badania opierają się na konkretnych pytaniach biomedycznych i wyzwaniach praktycznych. Rozwijamy dziedzinę poprzez metody odzwierciedlające strukturę danych, realia praktyki klinicznej i kluczowe decyzje stojące przed pacjentami, klinicystami i systemami ochrony zdrowia.
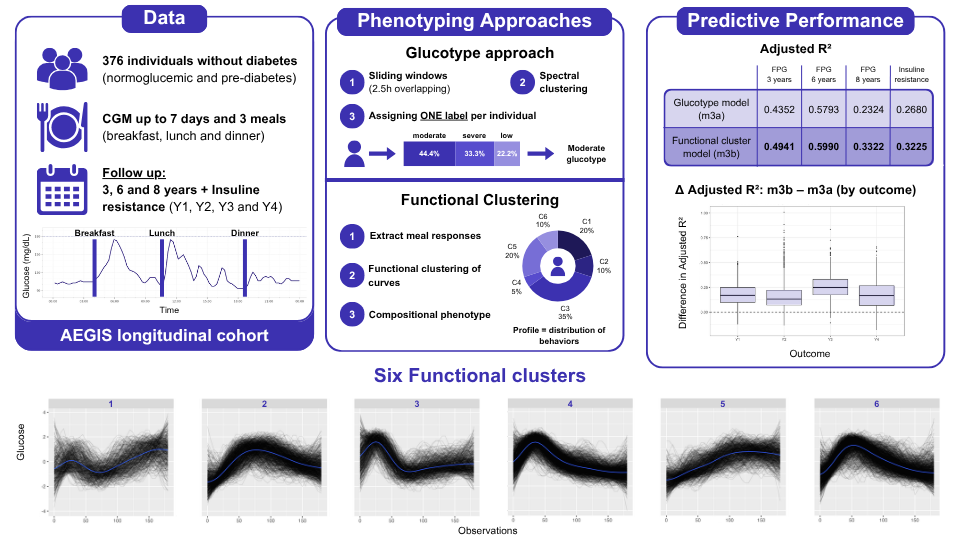
Siedem filarów naszego programu badań nad zdrowiem cyfrowym
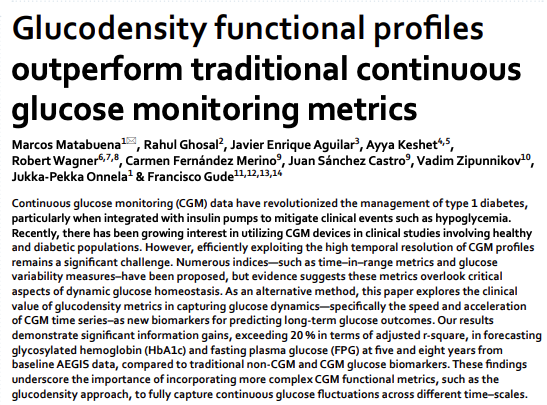
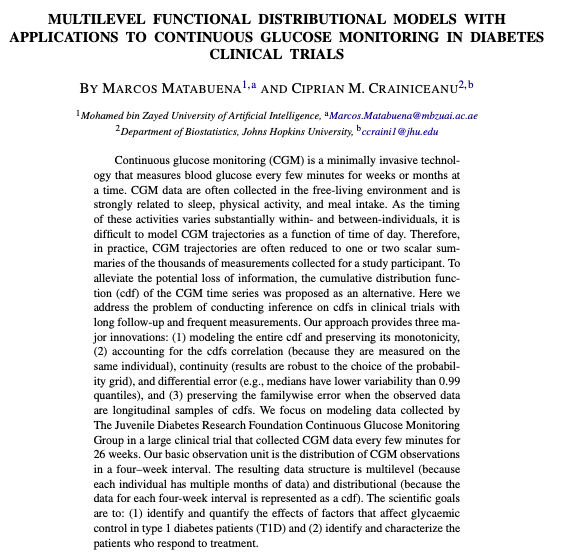
Naszych siedem artykułów stanowi istotny postęp metodologiczny i koncepcyjny w dziedzinie zdrowia cyfrowego.
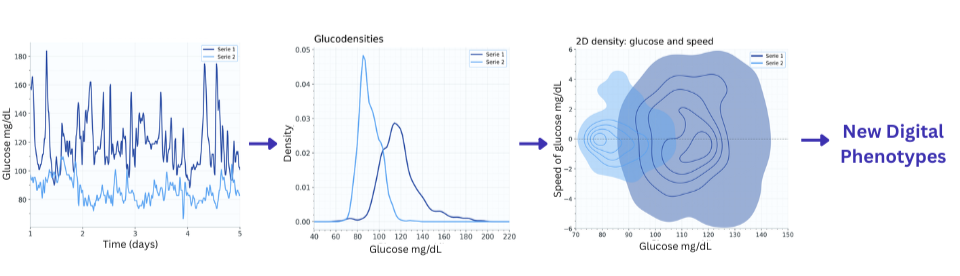
Wprowadzenie pojęcia glucodensity stanowi pierwszy krok ku tworzeniu bardziej złożonych fenotypów cyfrowych poprzez analizę danych funkcjonalnych i rozkładów. Podejście to otwiera nowe kierunki odkryć biologicznych i pozwala efektywniej wykorzystywać ciągłe informacje z nowych urządzeń medycznych, zamiast sprowadzać je do niewielkiej liczby miar skalarnych.
Wprowadzenie wielowymiarowego glucodensity stanowi kolejny krok koncepcyjny w analizie fizjologii człowieka. Dane kliniczne nie są już analizowane wyłącznie jako pojedyncze liczby, lecz jako złożone obiekty bliższe obrazom medycznym. Możemy teraz integrować dynamikę leżących u ich podstaw procesów fizjologicznych w jednolitych ramach rozkładowych glucodensity.
Wspólna praca z Ciprian Crainiceanu nad modelami efektów losowych dla danych glucodensity rozszerza te idee na badania podłużne trwające tygodnie, miesiące lub lata. Praca ta tworzy nowe ramy wykorzystania informacji cyfrowych w badaniach klinicznych, z możliwością zwiększenia mocy statystycznej i odkrywania nowych, bardziej istotnych biomarkerów podłużnych.
Wraz z Mateo Cámara, proponujemy pierwsze ramy modelowania efektów losowych w ogólnych przestrzeniach metrycznych, zapewniające jednolite podejście do analizy różnych typów obiektów statystycznych w badaniach klinicznych. Większość informacji zbieranych w zdrowiu cyfrowym jest niemal ciągła w czasie, mierzona w wielu skalach czasowych i ma naturalną strukturę wielopoziomową. Nasze ramy po raz pierwszy oferują ogólny sposób analitycznego modelowania tych złożonych źródeł zmienności w szerszym ujęciu matematycznym.
Ramy kwantyfikacji niepewności w przestrzeniach metrycznych, opracowane wspólnie z Gábor Lugosi, mają istotne znaczenie metodologiczne, ponieważ oferują formalną metodę kalibracji i oceny pokrycia warunkowego bez restrykcyjnych warunków gładkości. Jednocześnie otwierają ogólniejsze ramy kwantyfikacji niepewności dla biomarkerów przyszłości, coraz częściej reprezentowanych przez rozkłady, funkcje, obrazy, sieci lub inne złożone nieeuklidesowe obiekty losowe.
Praca z moimi chińskimi współpracownikami — Mingyang Yi, Zhiming Ma, a także Ruoyu Wang— nad modelami dyfuzyjnymi i błędem pomiaru otwiera możliwość uwzględnienia niepewności pomiarowej w podejmowaniu decyzji biomedycznych. Główna idea polega na wykorzystaniu ogólnych metod generatywnej sztucznej inteligencji w klasycznych statystycznych procedurach analizy błędu pomiaru, co pozwala bezpośrednio włączyć do analizy błędy czujników, pomiarów klinicznych i innych technologii biomedycznych.
Wreszcie powodzenie nowej epoki danych będzie zależeć również od rozwoju nowych schematów eksperymentów i doboru próby. We wspólnej pracy z Yating Zou i Michael Kosorok, proponujemy nową metodologię lasów losowych dla danych z badań o złożonym schemacie doboru próby. Metoda ma istotne znaczenie dla wnioskowania, ponieważ procedura bootstrap jest stosowana na poziomie węzłów. Otwiera to nowe możliwości teoretyczne poprawy działania metod uczenia maszynowego przy złożonych schematach losowania, a zarazem zapewnia uzasadniony sposób wykorzystywania dużych zbiorów danych o zdrowiu przy zachowaniu poprawnego wnioskowania o populacji docelowej.
Łącznie prace te wyznaczają główne filary naszego programu badawczego: nową reprezentację cyfrowych danych o zdrowiu, modelowanie podłużne i wielopoziomowe, kwantyfikację niepewności, korektę błędu pomiaru z wykorzystaniem generatywnej AI oraz statystycznie poprawne wnioskowanie na podstawie złożonych badań biomedycznych.
Dorobek badawczy z poprzednich lat
2026
Denoising Data with Measurement Error Using a Reproducing Kernel-based Diffusion Model
arXiv
·
14 Jul 2026
·
arxiv:2501.00212
EpiBinder: a multimodal framework for cell-type-specific prediction and interpretation of transcription factor binding
openRxiv
·
08 Jul 2026
·
10.64898/2026.07.06.736502
Pre-activity glycemic prediction prioritizes post-meal movement
openRxiv
·
24 Jun 2026
·
doi:10.64898/2026.06.22.26356272
Conformal and kNN Predictive Uncertainty Quantification Algorithms in Metric Spaces
arXiv
·
23 Jun 2026
·
arxiv:2507.15741
A Deep Learning-Based Predictive Algorithm for Metabolic Syndrome Detection in the U.S. Population
openRxiv
·
02 Jun 2026
·
doi:10.64898/2026.05.24.26354007
Capturing the Curve: Functional Data Analysis for Validated Digital Outcome Measures
arXiv
·
28 May 2026
·
arxiv:2605.28344
Gaussian mixture models in Hilbert spaces via kernel methods
arXiv
·
08 May 2026
·
arxiv:2605.05996
Screening for diabetes mellitus in the US population using neural network-based modeling and complex survey designs
Statistical Methods in Medical Research
·
07 May 2026
·
doi:10.1177/09622802261442893
Random-Effects Algorithm for Random Objects in Metric Spaces
arXiv
·
05 May 2026
·
arxiv:2605.02693
Continuous-Time Learning of Probability Distributions: A Case Study in a Digital Trial of Young Children with Type 1 Diabetes
arXiv
·
26 Mar 2026
·
arxiv:2603.24427
Multilevel functional distributional models with applications to continuous glucose monitoring in diabetes clinical trials
The Annals of Applied Statistics
·
01 Mar 2026
·
doi:10.1214/26-AOAS2139
Glucodensity-Based Models Outperform Time in Range and Glycemia Risk Index in Prediction Models
Journal of Diabetes Science and Technology
·
23 Feb 2026
·
doi:10.1177/19322968261421954
Survival on Image Regression With Application to Partially Functional Distributional Representation of Physical Activity
Statistical Analysis and Data Mining: An ASA Data Science Journal
·
01 Feb 2026
·
doi:10.1002/sam.70068
Exploratory analysis of smartphone-based step counts as a digital biomarker for survival in ALS patients
Frontiers in Digital Health
·
29 Jan 2026
·
doi:10.3389/fdgth.2025.1705368
Beyond scalar metrics: functional data analysis of postprandial continuous glucose monitoring in the AEGIS study
BMC Medical Research Methodology
·
24 Jan 2026
·
doi:10.1186/s12874-025-02748-2
Distributional Random Forests for Complex Survey Designs on Reproducing Kernel Hilbert Spaces
arXiv
·
07 Jan 2026
·
arxiv:2512.08179
Daily Physical Activity Patterns Enhance Mortality Prediction in NHANES 2011-2014: A Comparative Study Across Classical, Machine Learning, and Deep Learning Models Using Accelerometer Data
Journal for the Measurement of Physical Behaviour
·
01 Jan 2026
·
doi:10.1123/jmpb.2025-0052
From Physical Activity to Spirometry (as a Curve): A Combined Model for Mortality Prediction
Nieopublikowane
·
01 Jan 2026
·
doi:10.13140/RG.2.2.35806.60486
2025
Continuous Glucose Monitoring as an alternative for Cystic Fibrosis Related diabetes screening and diagnosis
Diabetes Research and Clinical Practice
·
01 Nov 2025
·
doi:10.1016/j.diabres.2025.112952
Unequal strides to longevity. The extra mile to health equity
Annals of Epidemiology
·
01 Nov 2025
·
doi:10.1016/j.annepidem.2025.10.009
kNN Algorithm for Conditional Mean and Variance Estimation with Automated Uncertainty Quantification and Variable Selection
arXiv
·
28 Oct 2025
·
arxiv:2402.01635
Variable Selection for Fixed and Random Effects in Multilevel Functional Mixed Effects Models
arXiv
·
24 Oct 2025
·
arxiv:2505.05416
ROC Analysis with Covariate Adjustment Using Neural Network Models: Evaluating the Role of Age in the Physical Activity-Mortality Association
arXiv
·
20 Oct 2025
·
arxiv:2510.14494
Glucodensity functional profiles outperform traditional continuous glucose monitoring metrics
Scientific Reports
·
29 Sep 2025
·
doi:10.1038/s41598-025-18119-2
Age, Sex, BMI, Meal Timing, and Glycemic Response to Meal Glycemic Load
JAMA Network Open
·
23 Sep 2025
·
doi:10.1001/jamanetworkopen.2025.33193
Continuous Temporal Learning of Probability Distributions via Neural ODEs with Applications in Continuous Glucose Monitoring Data
arXiv
·
18 Sep 2025
·
arxiv:2505.08698
Distributional Data Analysis Uncovers Hundreds of Novel and Heritable Phenomic Features from Temporal Cotton and Maize Drone Imagery
openRxiv
·
07 Sep 2025
·
doi:10.1101/2025.09.05.674557
Functional time transformation model with applications to digital health
Computational Statistics & Data Analysis
·
01 Jul 2025
·
doi:10.1016/j.csda.2025.108131
Model-Free Kernel Conformal Depth Measures Algorithm for Uncertainty Quantification in Regression Models in Separable Hilbert Spaces
arXiv
·
11 Jun 2025
·
arxiv:2506.08325
Conformal prediction for uncertainty quantification in dynamic biological systems
PLOS Computational Biology
·
12 May 2025
·
doi:10.1371/journal.pcbi.1013098
A Telehealth Program Using Continuous Glucose Monitoring and a Connected Insulin Pen Cap in Nursing Homes for Older Adults with Insulin-Treated Diabetes: The Trescasas Study
Diabetes Technology & Therapeutics
·
01 May 2025
·
doi:10.1089/dia.2024.0356
Uncertainty quantification for intervals
arXiv
·
01 Apr 2025
·
arxiv:2408.16381
Deep Learning Framework with Uncertainty Quantification for Survey Data: Assessing and Predicting Diabetes Mellitus Risk in the American Population
arXiv
·
27 Mar 2025
·
arXiv:2403.19752
Optimal Cut-Point Estimation for Functional Digital Biomarkers: Application to Diabetes Risk Stratification via Continuous Glucose Monitoring
arXiv
·
11 Mar 2025
·
arxiv:2404.09716
Causal survival embeddings: Non-parametric counterfactual inference under right-censoring
Statistical Methods in Medical Research
·
11 Feb 2025
·
doi:10.1177/09622802241311455
Kernel biclustering algorithm in Hilbert spaces
Advances in Data Analysis and Classification
·
21 Jan 2025
·
doi:10.1007/s11634-024-00619-0
Variable Selection Methods for Multivariate, Functional, and Complex Biomedical Data in the AI Age
arXiv
·
14 Jan 2025
·
arxiv:2501.06868
2024
Predicting distributions of physical activity profiles in the National Health and Nutrition Examination Survey database using a partially linear Fréchet single index model
Biostatistics
·
31 Dec 2024
·
doi:10.1093/biostatistics/kxaf013
Divergent hypoglycemic and hyperglycemic responses to the components of evening meals. A general adult population study in individuals without diabetes (AEGIS Study)
Clinical Nutrition
·
01 Dec 2024
·
doi:10.1016/j.clnu.2024.11.020
Exploring the Interplay Between Physical Activity, Dietary Patterns, Diabetes, and All-Cause Mortality in the U.S.A. Population, NHANES 2011-2014: A Distributional Data Analysis Perspective
Springer Science and Business Media LLC
·
15 Nov 2024
·
doi:10.21203/rs.3.rs-5314139/v1
Exploring the association between daily distributional patterns of physical activity and cardiovascular mortality risk among older adults in NHANES 2003-2006
Annals of Epidemiology
·
01 Nov 2024
·
doi:10.1016/j.annepidem.2024.10.001
Uncertainty Quantification in Dynamic Models of Biological Systems Using Conformal Prediction
[object Object]
·
01 Oct 2024
·
doi: 10.5281/zenodo.13838652
Book Review: Functional Data Analysis with R by Ciprian M. Crainiceanu, Jeff Goldsmith, Andrew Leroux, and Erjia Cui
Journal of Agricultural, Biological and Environmental Statistics
·
01 Oct 2024
·
doi:10.1007/s13253-024-00656-4
Multivariate scalar on multidimensional distribution regression with application to modeling the association between physical activity and cognitive functions
Biometrical Journal
·
22 Sep 2024
·
doi:10.1002/bimj.202400042
Neural interval-censored survival regression with feature selection
Statistical Analysis and Data Mining: The ASA Data Science Journal
·
16 Jul 2024
·
doi:10.1002/sam.11704
Energy Distance and Kernel Mean Embeddings for Two-Sample Survival Testing with Applications in Immunotherapy Clinical Trials
REVSTAT-Statistical Journal
·
14 Jun 2024
·
doi:10.57805/revstat.vi.572
Conformal uncertainty quantification using kernel depth measures in separable Hilbert spaces
arXiv
·
24 May 2024
·
arxiv:2405.13970
Uncertainty quantification in metric spaces
arXiv
·
09 May 2024
·
arxiv:2405.05110
Insulin glargine 300 U/ml versus insulin degludec 100 U/ml improves nocturnal glycaemic control and variability in type 1 diabetes under routine clinical practice: A glucodensities-based post hoc analysis of the OneCare study
Diabetes, Obesity and Metabolism
·
01 May 2024
·
doi: 10.1111/dom.15496
Insulin glargine 300 U/ml versus insulin degludec 100 U/ml improves nocturnal glycaemic control and variability in type 1 diabetes under routine clinical practice: A glucodensities-based post hoc analysis of the OneCare study
Diabetes, Obesity and Metabolism
·
20 Feb 2024
·
doi:10.1111/dom.15496
Author Correction: Reassessment of fluctuating dental asymmetry in Down syndrome
Scientific Reports
·
16 Jan 2024
·
doi:10.1038/s41598-024-51672-w
2021
Glucodensities: A new representation of glucose profiles using distributional data analysis
Statistical Methods in Medical Research
·
01 Jun 2021
·
doi: 10.1177/0962280221998064