Fenotypowanie cyfrowe i spersonalizowana opieka zdrowotna
Jak przekształcać ciągłe dane fizjologiczne i wielomodalne dane biologiczne w odtwarzalne fenotypy cyfrowe dla medycyny spersonalizowanej?
Nasze projekty mają stworzyć rygorystyczne podstawy metodologiczne biostatystyki cyfrowej i wykazać ich praktyczną wartość w badaniach biomedycznych, praktyce klinicznej i ochronie zdrowia populacji. Opracowujemy metody statystyczne potrzebne do przekształcania ciągłych, podłużnych i wielomodalnych danych o zdrowiu w wiarygodną wiedzę biomedyczną i decyzje o znaczeniu klinicznym. Pracę tę organizujemy wokół trzech powiązanych programów badawczych, których nadrzędnym celem jest rzeczywisty wpływ na zdrowie metaboliczne, opiekę diabetologiczną i spersonalizowane żywienie.
Jak przekształcać ciągłe dane fizjologiczne i wielomodalne dane biologiczne w odtwarzalne fenotypy cyfrowe dla medycyny spersonalizowanej?
Czy niemal ciągłe pomiary cyfrowe mogą wykrywać klinicznie istotne zmiany wcześniej niż konwencjonalne oceny kliniczne?
Jak cyfrowe dane o zdrowiu mogą usprawnić nadzór epidemiologiczny, profilaktykę i planowanie opieki zdrowotnej na poziomie populacji?
Nasze badania skupiają się wokół otwartych pytań metodologicznych, stosowanych i klinicznych. Wyznaczają one kierunek rozwoju nowej teorii statystycznej, a zarazem zapewniają, że powstające metody odpowiadają na istotne problemy medycyny i zdrowia publicznego.
Jak na podstawie wartości e opracować ogólne ramy wielokrotnego testowania hipotez na dużą skalę w wysokowymiarowych badaniach nad zdrowiem cyfrowym?
Jak rozszerzyć predykcję konformalną na modele wielopoziomowe i modele efektów losowych, zachowując użyteczne gwarancje pokrycia brzegowego i warunkowego?
Jak konstruować obszary predykcyjne dla obiektów losowych w przestrzeniach metrycznych, zapewniające silne gwarancje pokrycia warunkowego bez restrykcyjnych założeń o gładkości?
Jakie gwarancje teoretyczne można ustalić dla algorytmów uczenia głębokiego działających w ogólnych przestrzeniach nieeuklidesowych, bez założenia, że obserwacje leżą na gładkiej rozmaitości, z myślą o współczesnych zastosowaniach w zdrowiu cyfrowym?
Jakie podstawy matematyczne i statystyczne są potrzebne, aby analiza danych rozkładowych stała się rygorystycznym, interpretowalnym i szeroko stosowanym podejściem do zdrowia cyfrowego?
Obok tych wyzwań metodologicznych badamy ważne pytania stosowane, w których zaawansowane metody statystyczne mogą przynieść wymierną wartość kliniczną i biomedyczną.
Czy fenotypy cyfrowe mogą ujawniać powiązania genetyczne niewykrywane przez konwencjonalne biomarkery kliniczne?
Czy glucodensity i pokrewne reprezentacje rozkładowe można zwalidować jako odporne, odtwarzalne i bardziej informacyjne biomarkery cyfrowe zdrowia metabolicznego?
Jaką rolę odgrywa zmienność glikemii w relacji między mikrobiomem a zdrowiem metabolicznym i jak dane z ciągłego monitorowania glukozy mogą pomóc lepiej ją scharakteryzować?
Jak fenotypy uzyskane z ciągłego monitorowania glukozy wiążą się z retinopatią cukrzycową i innymi powikłaniami mikronaczyniowymi?
Jak przekształcać ciągłe sygnały fizjologiczne w klinicznie istotne i odtwarzalne fenotypy cyfrowe oraz czego potrzeba do stworzenia rygorystycznych ram fenotypowania opartego na CGM w populacjach bez cukrzycy?
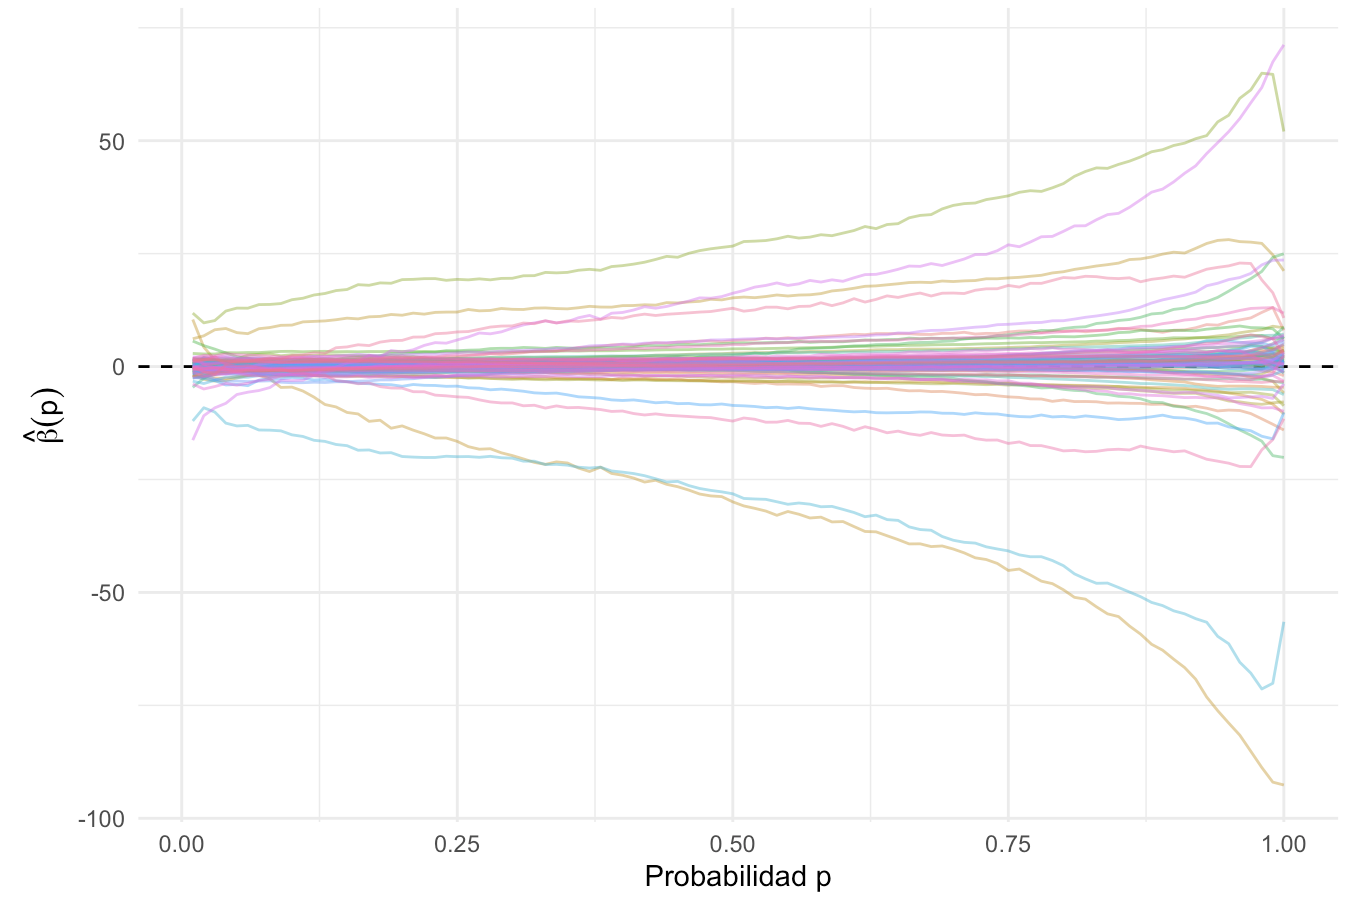
Opracowywanie modeli statystycznej AI integrujących wielomodalne cyfrowe dane o zdrowiu, obrazowanie medyczne, dane genomowe i mikrobiomowe z Human Phenotype Project, z zastosowaniami dotyczącymi ryzyka retinopatii, metabolizmu glukozy i funkcjonalnych cyfrowych fenotypów zdrowia.
Opracowywanie czasowo-przestrzennych metod statystycznych i metod uczenia maszynowego do analizy cyfrowych danych o zdrowiu z urządzeń ubieralnych, systemów CGM i elektronicznej dokumentacji medycznej, w celu mapowania ryzyka cukrzycy i kontroli metabolicznej w przestrzeni i czasie.
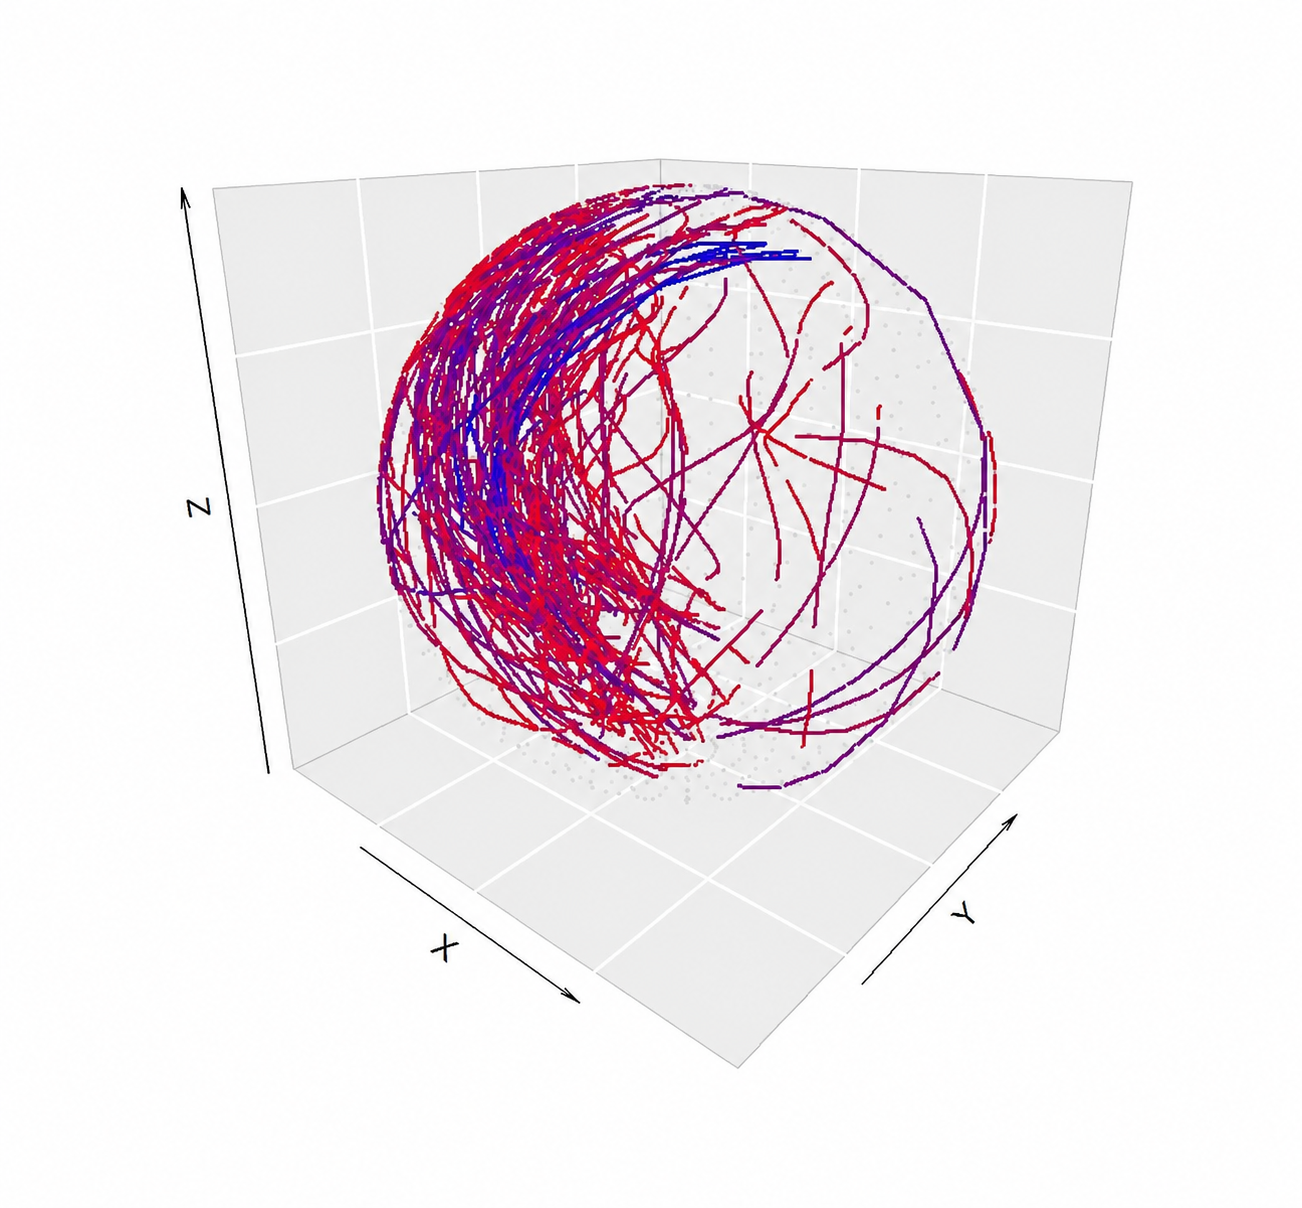
Opracowywanie biomarkerów funkcjonalnych i rozkładowych na podstawie niemal ciągłych danych o ruchach dłoni, aby usprawnić monitorowanie progresji stwardnienia zanikowego bocznego i prognozowanie przeżycia.