数字表型分析与个体化健康
如何将连续生理数据与多模态生物数据转化为可重复的数字表型,用于个体化医疗?
我们的项目旨在为数字生物统计学建立严谨的方法学基础,同时验证其在生物医学研究、临床实践和人群健康中的实际价值。我们开发统计方法,将连续、纵向、多模态健康数据转化为可靠的生物医学知识和有临床意义的决策。研究围绕三个相互关联的计划展开,整体目标是在代谢健康、糖尿病照护和个体化营养方面产生实际影响。
如何将连续生理数据与多模态生物数据转化为可重复的数字表型,用于个体化医疗?
近乎连续的数字测量能否比传统临床评估更早发现具有临床意义的变化?
数字健康数据如何改善人群层面的监测、预防与医疗卫生规划?
我们的研究围绕尚未解决的方法学、应用和临床问题展开。这些问题引导新统计理论的发展,并确保由此产生的方法能够应对医学与公共卫生中的重要问题。
如何将 e 值发展为通用框架,用于高维数字健康研究中的大规模多重假设检验?
如何将共形预测扩展至多层模型和随机效应模型,同时保留有意义的边际与条件覆盖率保证?
如何为度量空间中的随机对象构建预测区域,在不依赖苛刻光滑性假设的前提下提供有力的条件覆盖率保证?
以现代数字健康应用为出发点,在不假设观测值位于光滑流形上的情况下,能够为一般非欧几里得空间中的深度学习算法建立哪些理论保证?
要使分布型数据分析成为严谨、可解释且广泛适用于数字健康的框架,需要哪些数学与统计基础?
在研究这些方法学挑战的同时,我们也探索重要的应用问题,使先进统计方法能够产生切实的临床和生物医学价值。
数字表型能否揭示传统临床生物标志物无法检测到的遗传关联?
能否验证葡萄糖密度及相关分布表示是稳健、可重复且信息更丰富的代谢健康数字生物标志物?
血糖变异性在微生物组与代谢健康的关系中发挥什么作用?持续血糖监测数据如何帮助更好地刻画这一关系?
持续血糖监测表型与糖尿病视网膜病变及其他微血管并发症有何关联?
如何将连续生理信号转化为具有临床意义、可重复的数字表型?在无糖尿病人群中建立严谨的持续血糖监测表型分析框架,需要满足哪些条件?
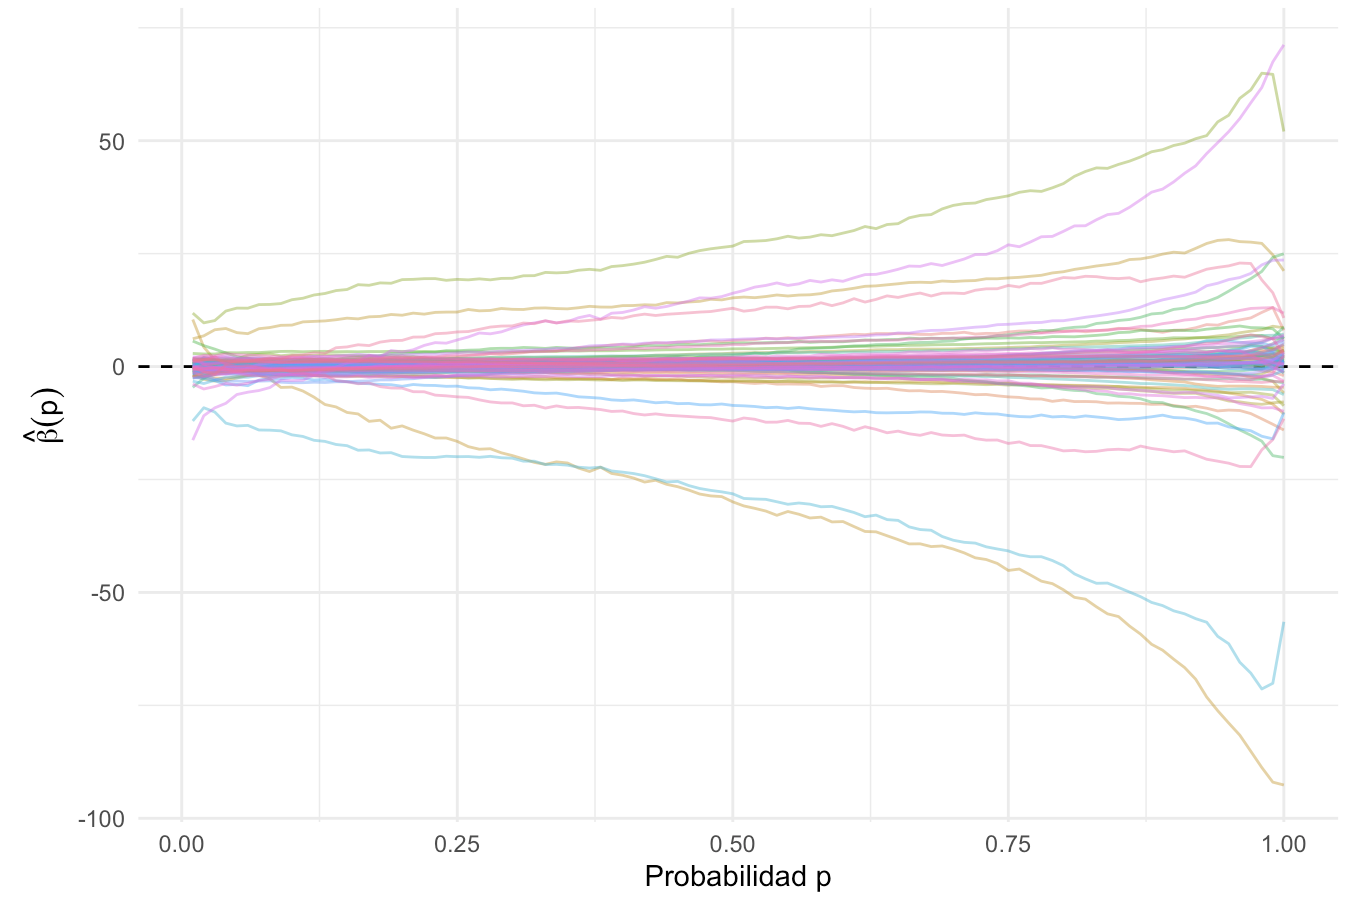
开发统计人工智能模型,整合 Human Phenotype Project 的多模态数字健康、医学影像、基因组与微生物组数据,应用于视网膜病变风险、葡萄糖代谢和函数型数字健康表型研究。
开发时空统计与机器学习方法,分析可穿戴设备、持续血糖监测系统和电子健康记录产生的数字健康数据,以描绘糖尿病风险及代谢控制在空间和时间上的分布。
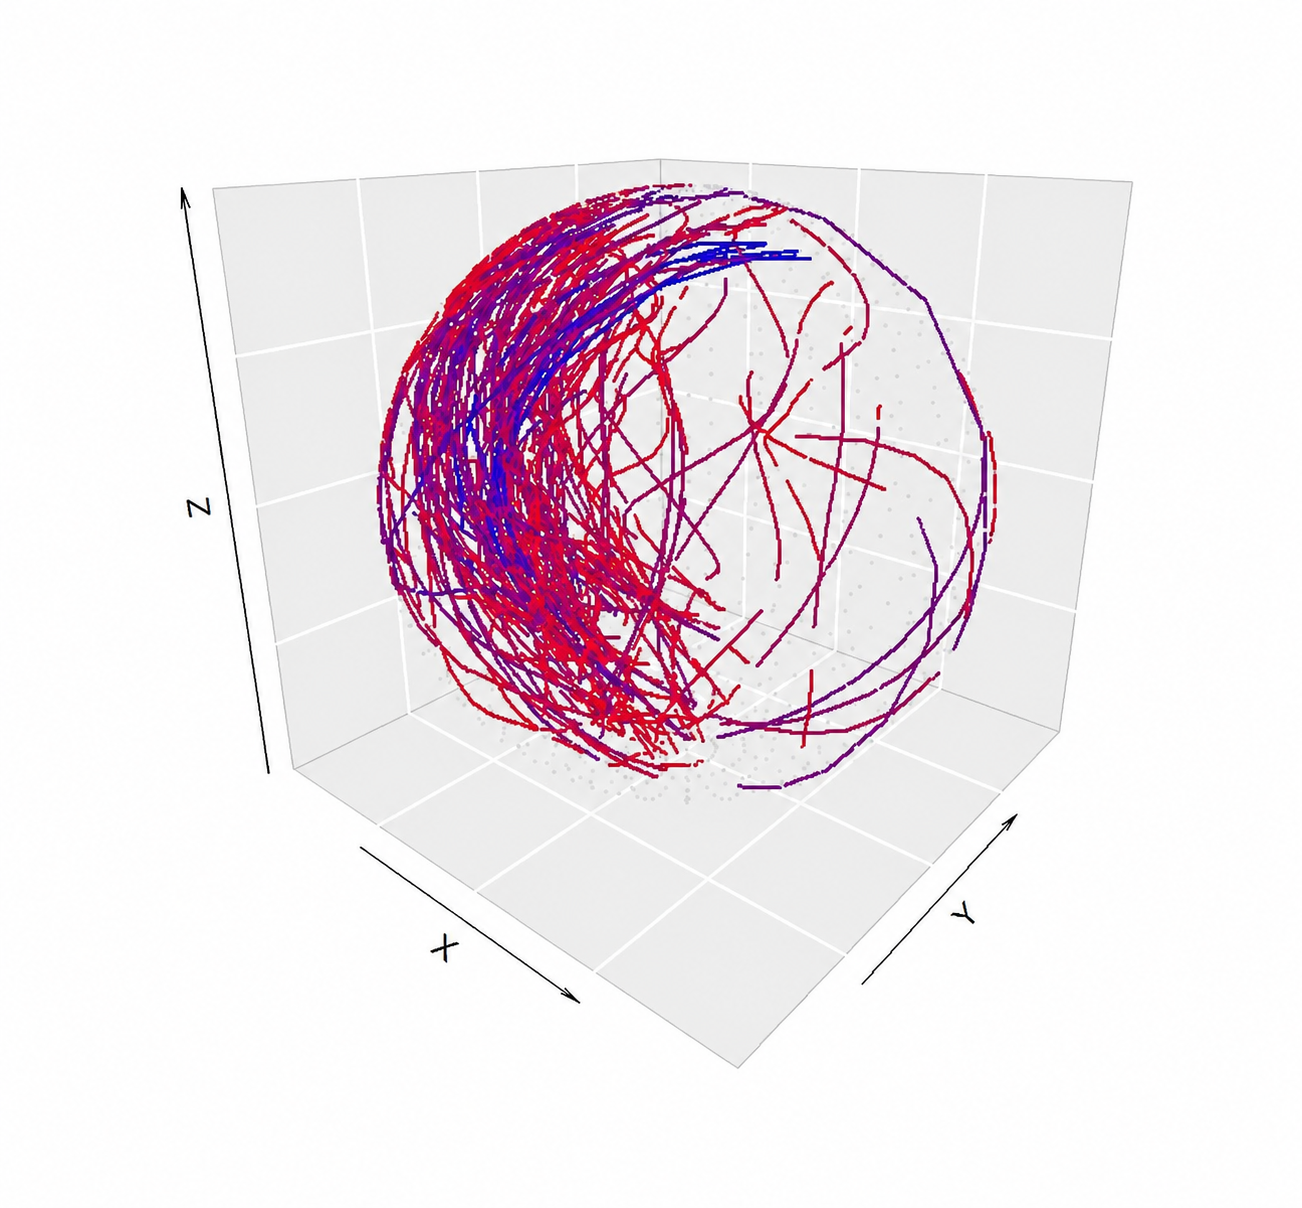
利用近乎连续的手部运动数据开发函数型与分布型生物标志物,改善肌萎缩侧索硬化症进展的监测与生存预测。