Исследования
Будущее, которое уже наступает
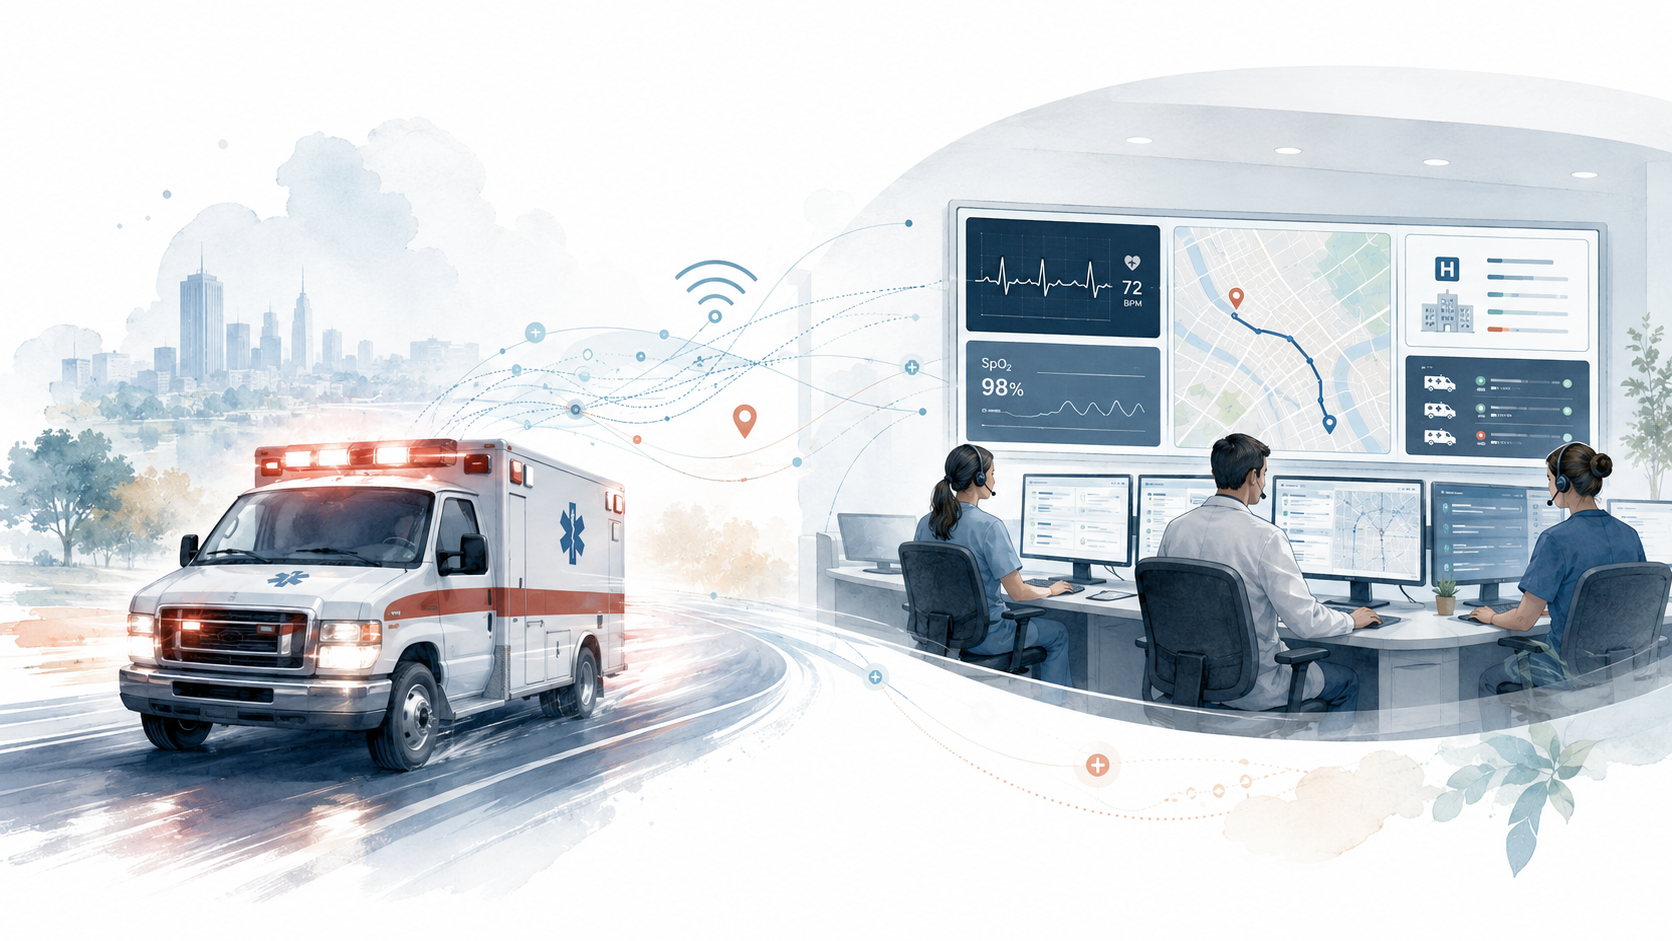
Представьте человека, у которого дома, в одиночестве, развивается острый коронарный синдром и который носит устройство непрерывного мониторинга жизненно важных показателей. Обнаружив критические изменения, например отклонения на электрокардиограмме или снижение уровня кислорода, устройство автоматически инициирует экстренную помощь. За считанные секунды система находит и направляет ближайшую свободную бригаду скорой помощи, учитывая в реальном времени дорожную обстановку и возможности больниц.
Во время транспортировки устройство непрерывно передаёт ключевые данные о пациенте, позволяя оперативно пересматривать широкий круг медицинских и логистических решений. Если состояние пациента ухудшается, больница получает предупреждение для подготовки отделения интенсивной терапии. По прибытии прогностические модели помогают принимать решения, обеспечивая наилучший возможный исход при максимально эффективном использовании ресурсов здравоохранения.
Наша миссия и видение
Наша долгосрочная цель — создать систему принятия решений в здравоохранении, которая улучшит клинические и общественно-медицинские решения на уровне отдельных людей и населения, объединяя биостатистику, цифровые технологии здравоохранения и исследование операций.
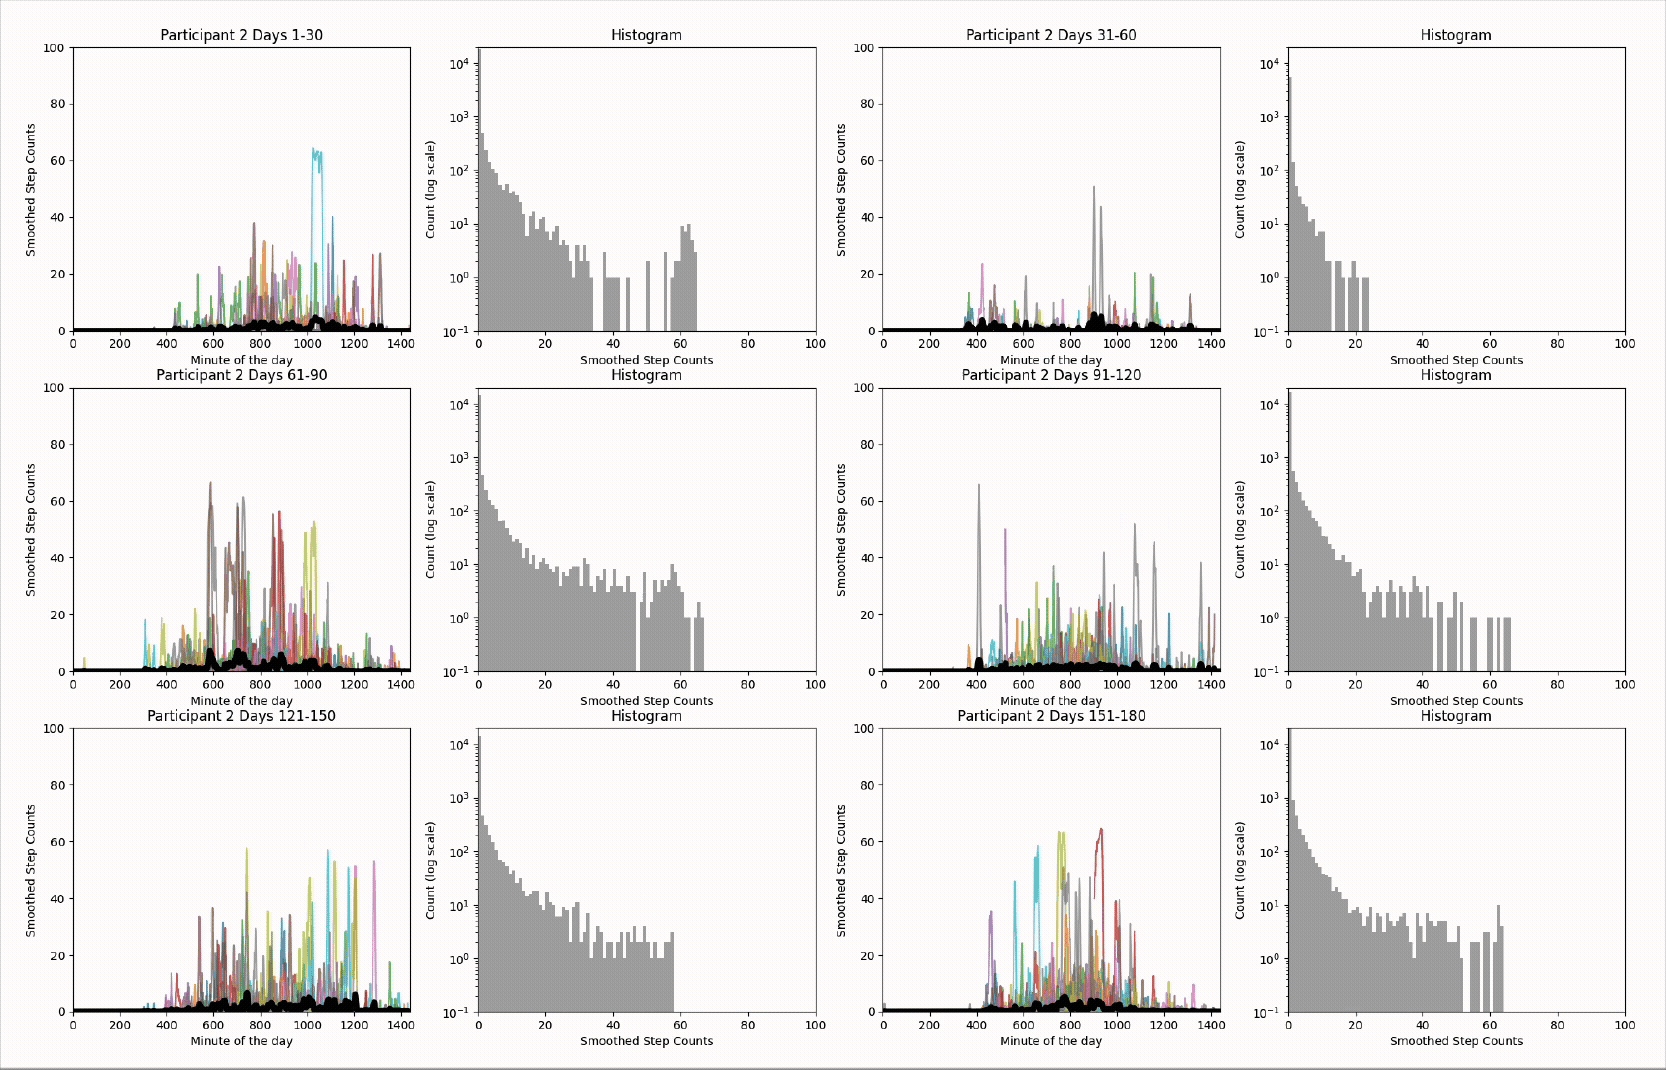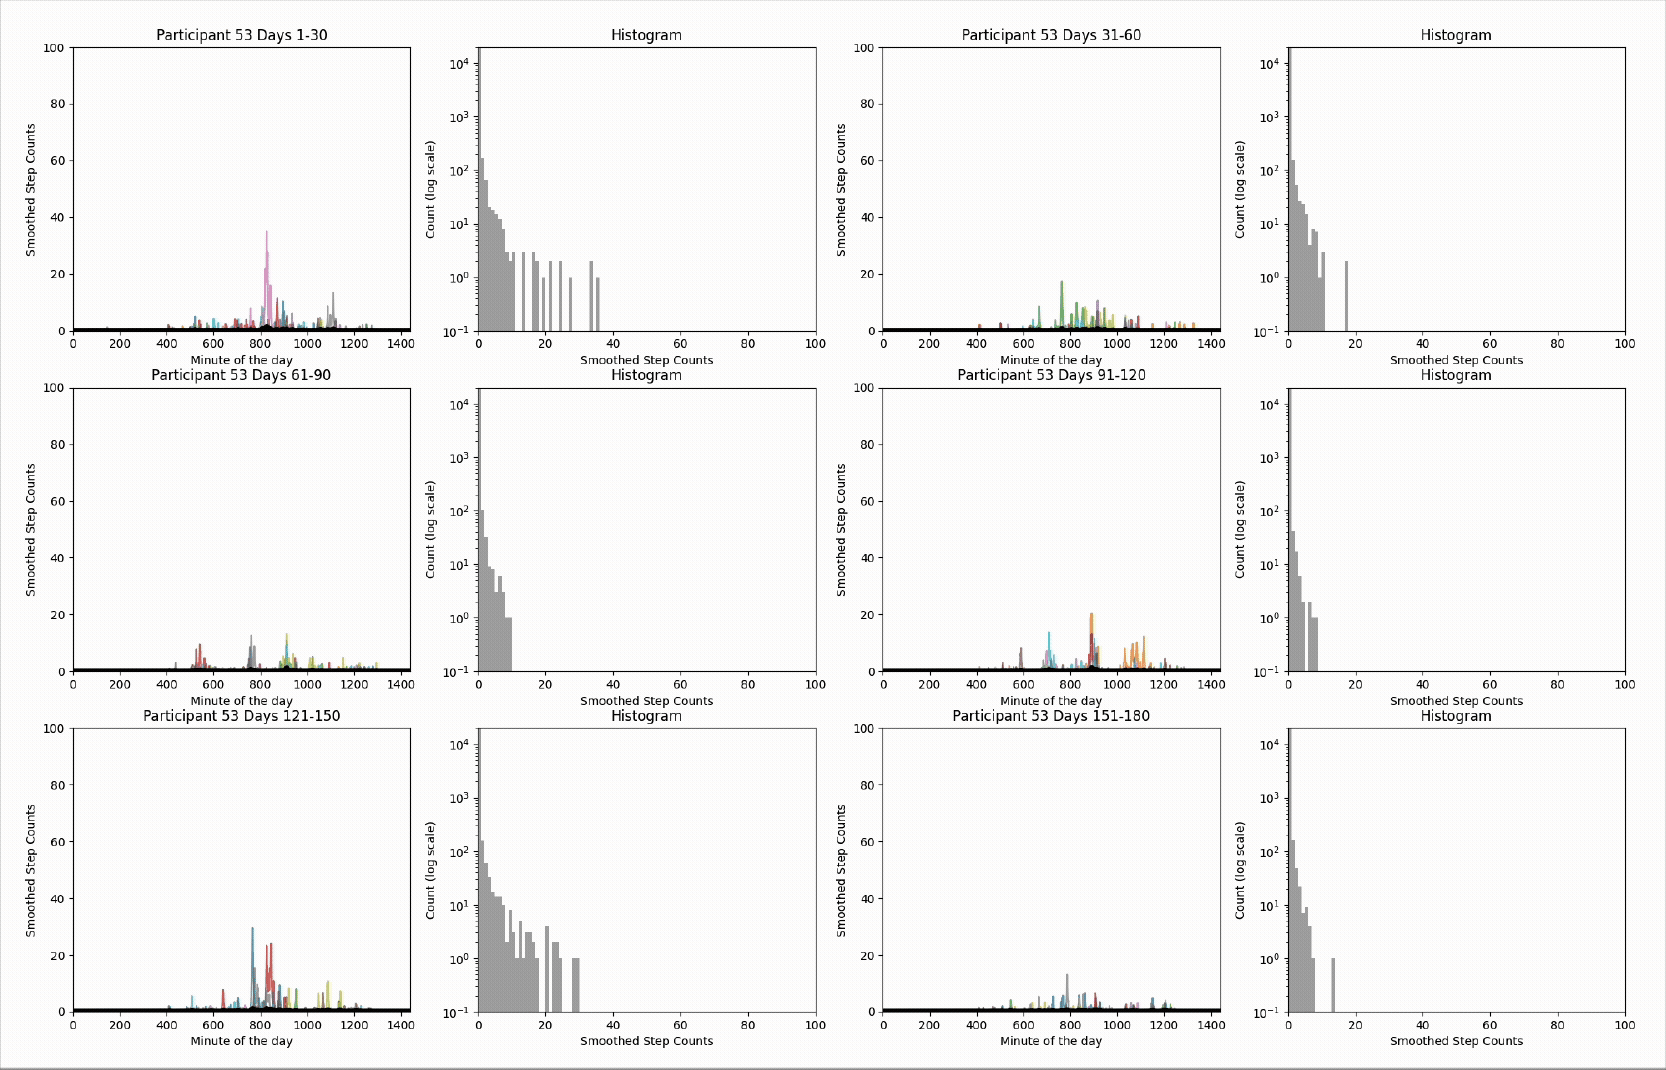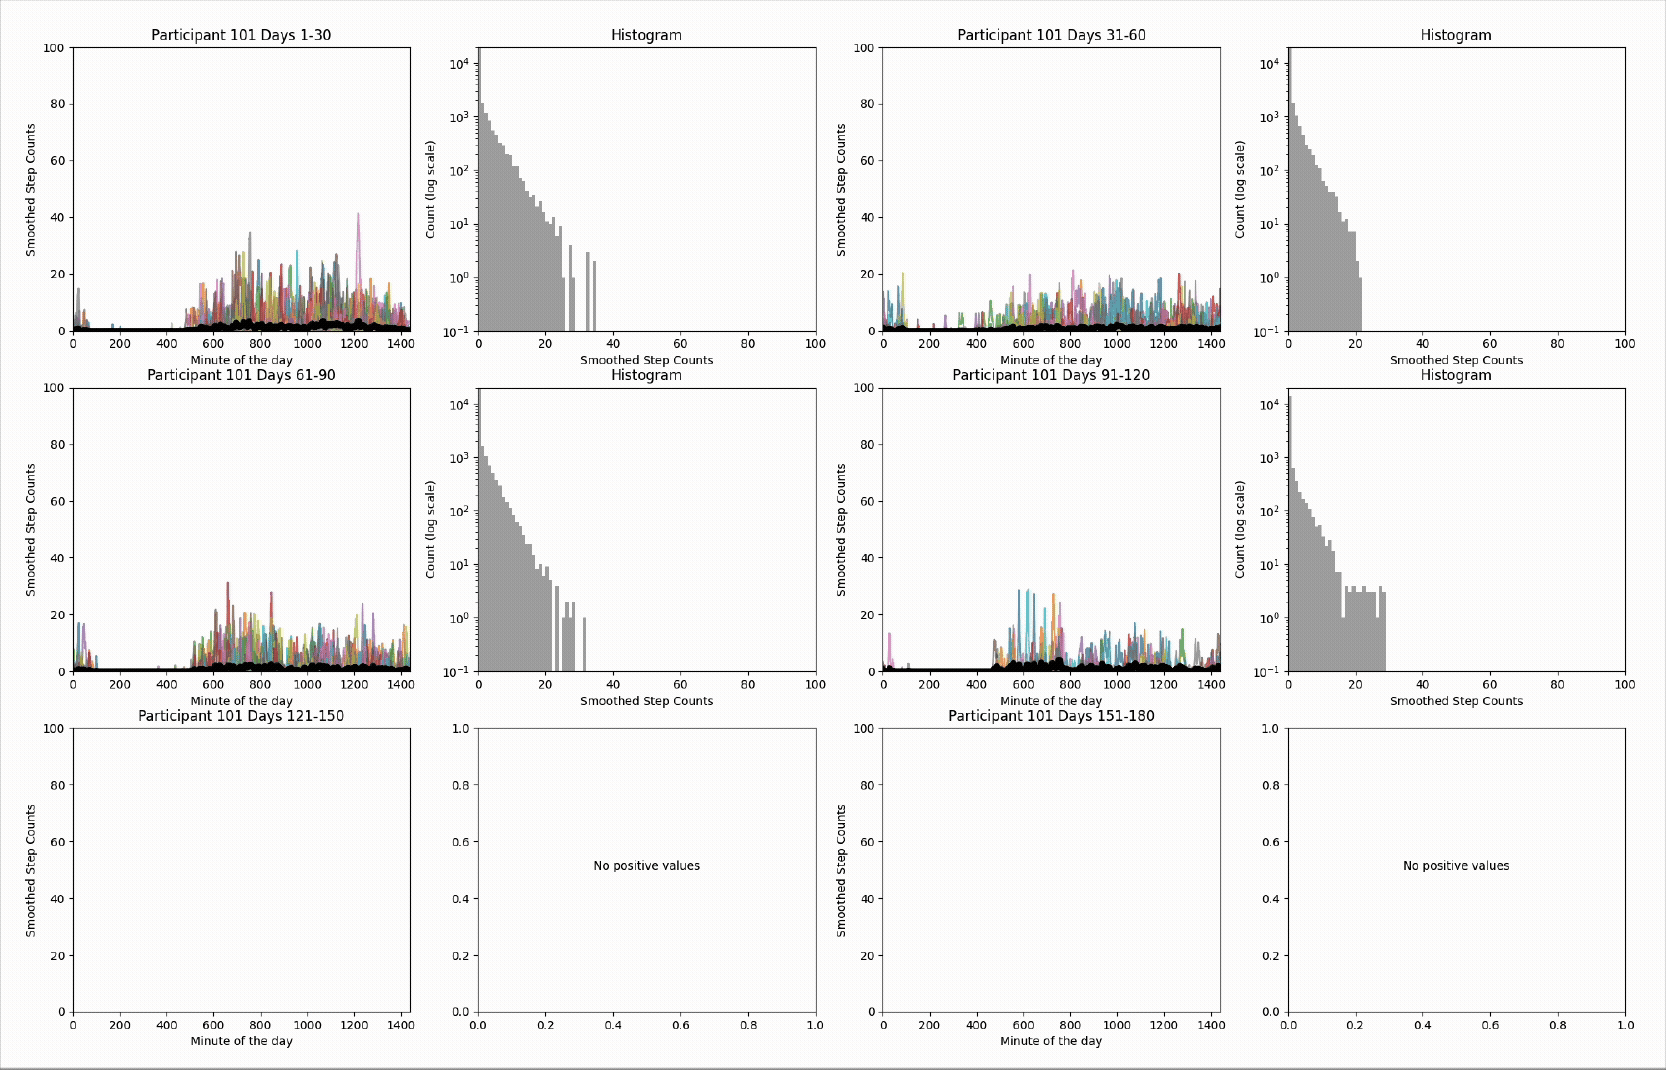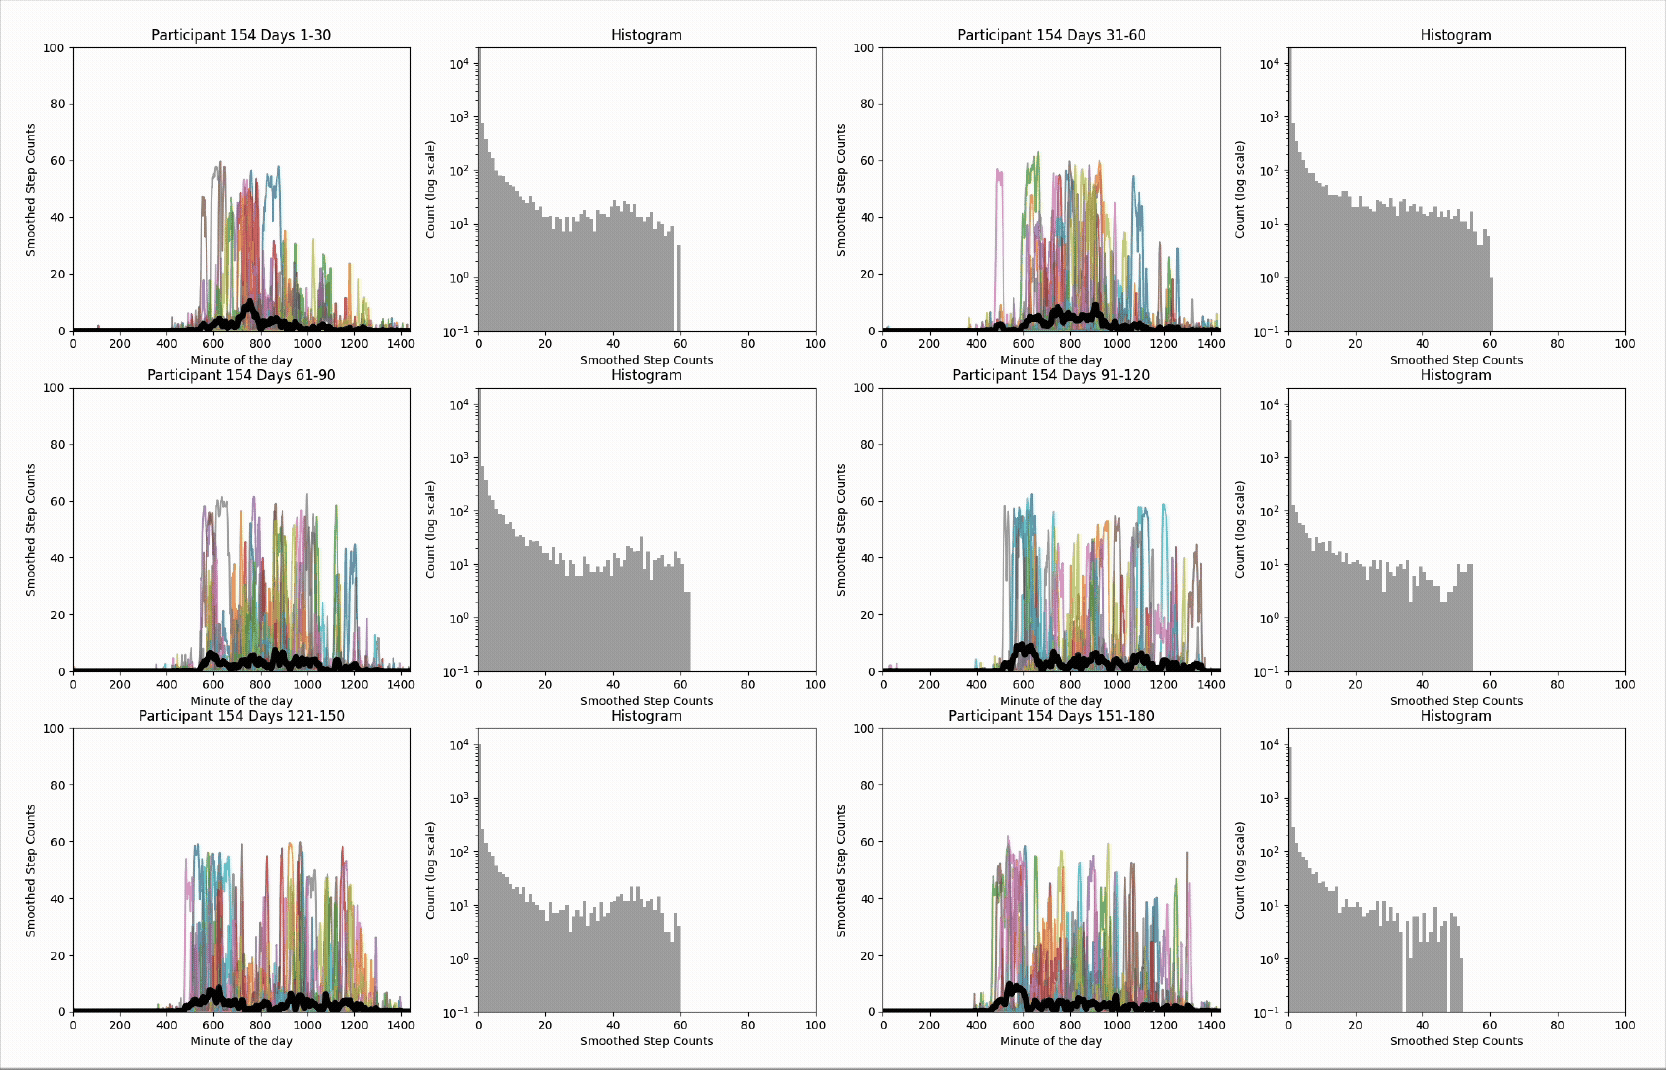
Сейчас мы разрабатываем статистические методы и методы искусственного интеллекта для сложных клинических задач, связанных с непрерывными, высокочастотными данными о здоровье, поступающими в реальном времени. Мы хотим, чтобы эти методы не только отвечали на существующие медицинские вопросы, но и помогали определять самые важные из них. Какой рацион лучше всего подходит конкретному человеку? Сколько физической активности необходимо для здорового старения и долголетия? Как должны меняться эти рекомендации в зависимости от клинического профиля, биологии, окружающей среды и образа жизни человека?
Для решения этих задач мы объединяем современные методы статистического ИИ для причинного вывода, анализа выживаемости, оценки неопределённости и генеративного моделирования со случайными эффектами, развивая статистическое обучение для неевклидовых случайных объектов. Тщательное планирование исследований и вычислительная масштабируемость имеют здесь ключевое значение. Мы стремимся создавать математически строгие и одновременно вычислительно эффективные методы, применимые в масштабе населения, ориентируясь на такие биомедицинские ресурсы, как UK Biobank, All of Us Research Program, Human Phenotype Project и NHANES.
Хотя многие методы, публикуемые в ведущих методологических журналах, отличаются математической строгостью и технической корректностью, они не всегда учитывают сложности и гипотезы, возникающие при работе с реальными клиническими данными. Поэтому наши исследования опираются на конкретные биомедицинские вопросы и практические задачи. Развивая эту область, мы создаём методы, учитывающие структуру данных, реалии клинической практики и важнейшие решения, с которыми сталкиваются пациенты, врачи и системы здравоохранения.
Семь основ нашей исследовательской программы в цифровом здравоохранении
Наши семь статей представляют собой существенный методологический и концептуальный вклад в развитие цифрового здравоохранения.
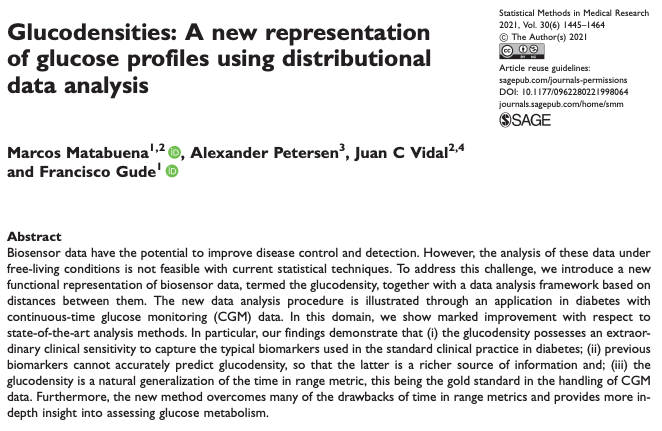
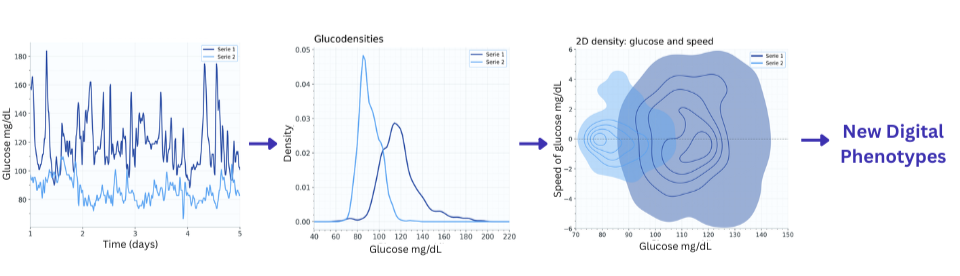
Введение понятия глюкоплотности (glucodensity) — первый шаг к созданию более сложных цифровых фенотипов с помощью анализа функциональных и распределительных данных. Этот подход открывает новые направления биологических открытий и позволяет эффективнее использовать непрерывную информацию с новых медицинских устройств, не сводя её к небольшому набору скалярных показателей.
Введение многомерной глюкоплотности стало следующим концептуальным шагом в анализе физиологии человека. Клинические данные теперь рассматриваются не только как отдельные числа, но и как сложные объекты, близкие по своей природе к медицинским изображениям. Динамику лежащих в их основе физиологических процессов можно объединить в единой распределительной модели глюкоплотности.
Совместная работа с Ciprian Crainiceanu над моделями со случайными эффектами для данных глюкоплотности переносит эти идеи на продольные исследования длительностью в недели, месяцы и годы. Эта работа создаёт новую основу для использования цифровой информации в клинических испытаниях, позволяя повысить статистическую мощность и выявлять новые, более значимые продольные биомаркеры.
Вместе с Mateo Cámara, мы предлагаем первую общую систему моделирования со случайными эффектами в метрических пространствах, обеспечивающую единый подход к анализу разных типов статистических объектов в клинических исследованиях. Большая часть информации в цифровом здравоохранении почти непрерывна во времени, измеряется в нескольких временных масштабах и естественным образом имеет многоуровневую структуру. Наш подход впервые даёт общий аналитический способ моделировать эти сложные источники вариации в более широкой математической постановке.
Подход к количественной оценке неопределённости в метрических пространствах, разработанный совместно с Gábor Lugosi, имеет важное методологическое значение, поскольку даёт формальный метод калибровки и оценки условного покрытия без жёстких требований к гладкости. Одновременно он создаёт более общую основу оценки неопределённости для биомаркеров будущего, которые всё чаще будут представлены распределениями, функциями, изображениями, сетями и другими сложными неевклидовыми случайными объектами.
Работа с моими китайскими коллегами — Mingyang Yi, Zhiming Ma, а также Ruoyu Wang— над диффузионными моделями и ошибками измерений позволяет учитывать неопределённость измерений при принятии биомедицинских решений. Основная идея состоит в использовании общих методов генеративного искусственного интеллекта в классических статистических схемах учёта ошибок измерений, чтобы непосредственно включать в анализ погрешности датчиков, клинических измерений и других биомедицинских технологий.
Наконец, успех новой эпохи данных будет также зависеть от разработки новых планов экспериментов и выборочных исследований. В совместной работе с Yating Zou и Michael Kosorok, мы предлагаем новую методологию случайного леса для данных обследований со сложным дизайном выборки. Метод имеет важные следствия для статистического вывода, поскольку процедура бутстрэпа применяется на уровне узлов. Это открывает новые теоретические возможности для улучшения машинного обучения при сложных схемах выборки и одновременно даёт обоснованный способ использовать крупные массивы данных о здоровье, сохраняя корректность выводов для целевой популяции.
Вместе эти работы определяют основные направления нашей исследовательской программы: новое представление цифровых данных о здоровье, продольное и многоуровневое моделирование, оценку неопределённости, коррекцию ошибок измерений с помощью генеративного ИИ и статистически корректный вывод на основе сложных биомедицинских исследований.
Результаты исследований прошлых лет
2026
Denoising Data with Measurement Error Using a Reproducing Kernel-based Diffusion Model
arXiv
·
14 Jul 2026
·
arxiv:2501.00212
EpiBinder: a multimodal framework for cell-type-specific prediction and interpretation of transcription factor binding
openRxiv
·
08 Jul 2026
·
10.64898/2026.07.06.736502
Pre-activity glycemic prediction prioritizes post-meal movement
openRxiv
·
24 Jun 2026
·
doi:10.64898/2026.06.22.26356272
Conformal and kNN Predictive Uncertainty Quantification Algorithms in Metric Spaces
arXiv
·
23 Jun 2026
·
arxiv:2507.15741
A Deep Learning-Based Predictive Algorithm for Metabolic Syndrome Detection in the U.S. Population
openRxiv
·
02 Jun 2026
·
doi:10.64898/2026.05.24.26354007
Capturing the Curve: Functional Data Analysis for Validated Digital Outcome Measures
arXiv
·
28 May 2026
·
arxiv:2605.28344
Gaussian mixture models in Hilbert spaces via kernel methods
arXiv
·
08 May 2026
·
arxiv:2605.05996
Screening for diabetes mellitus in the US population using neural network-based modeling and complex survey designs
Statistical Methods in Medical Research
·
07 May 2026
·
doi:10.1177/09622802261442893
Random-Effects Algorithm for Random Objects in Metric Spaces
arXiv
·
05 May 2026
·
arxiv:2605.02693
Continuous-Time Learning of Probability Distributions: A Case Study in a Digital Trial of Young Children with Type 1 Diabetes
arXiv
·
26 Mar 2026
·
arxiv:2603.24427
Multilevel functional distributional models with applications to continuous glucose monitoring in diabetes clinical trials
The Annals of Applied Statistics
·
01 Mar 2026
·
doi:10.1214/26-AOAS2139
Glucodensity-Based Models Outperform Time in Range and Glycemia Risk Index in Prediction Models
Journal of Diabetes Science and Technology
·
23 Feb 2026
·
doi:10.1177/19322968261421954
Survival on Image Regression With Application to Partially Functional Distributional Representation of Physical Activity
Statistical Analysis and Data Mining: An ASA Data Science Journal
·
01 Feb 2026
·
doi:10.1002/sam.70068
Exploratory analysis of smartphone-based step counts as a digital biomarker for survival in ALS patients
Frontiers in Digital Health
·
29 Jan 2026
·
doi:10.3389/fdgth.2025.1705368
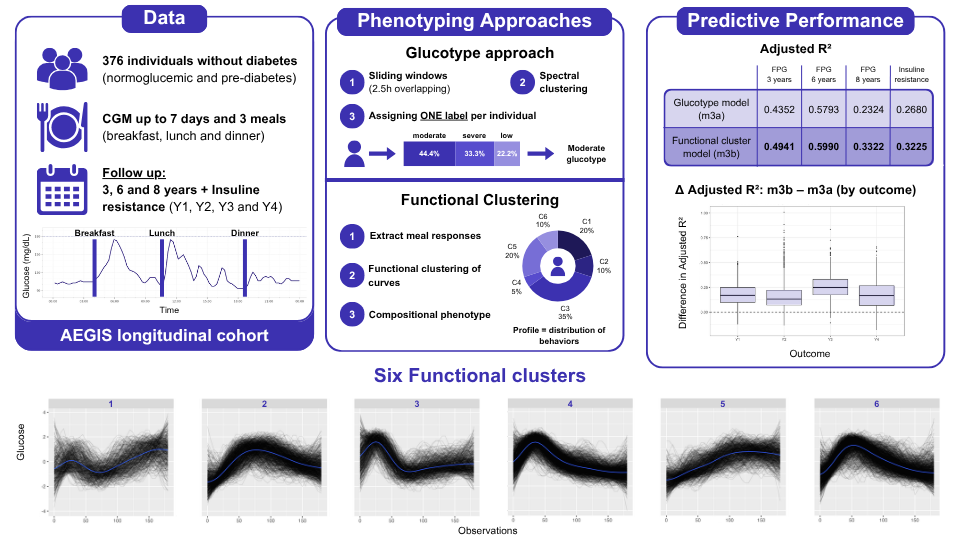
Beyond scalar metrics: functional data analysis of postprandial continuous glucose monitoring in the AEGIS study
BMC Medical Research Methodology
·
24 Jan 2026
·
doi:10.1186/s12874-025-02748-2
Distributional Random Forests for Complex Survey Designs on Reproducing Kernel Hilbert Spaces
arXiv
·
07 Jan 2026
·
arxiv:2512.08179
Daily Physical Activity Patterns Enhance Mortality Prediction in NHANES 2011-2014: A Comparative Study Across Classical, Machine Learning, and Deep Learning Models Using Accelerometer Data
Journal for the Measurement of Physical Behaviour
·
01 Jan 2026
·
doi:10.1123/jmpb.2025-0052
From Physical Activity to Spirometry (as a Curve): A Combined Model for Mortality Prediction
Не опубликовано
·
01 Jan 2026
·
doi:10.13140/RG.2.2.35806.60486
2025
Continuous Glucose Monitoring as an alternative for Cystic Fibrosis Related diabetes screening and diagnosis
Diabetes Research and Clinical Practice
·
01 Nov 2025
·
doi:10.1016/j.diabres.2025.112952
Unequal strides to longevity. The extra mile to health equity
Annals of Epidemiology
·
01 Nov 2025
·
doi:10.1016/j.annepidem.2025.10.009
kNN Algorithm for Conditional Mean and Variance Estimation with Automated Uncertainty Quantification and Variable Selection
arXiv
·
28 Oct 2025
·
arxiv:2402.01635
Variable Selection for Fixed and Random Effects in Multilevel Functional Mixed Effects Models
arXiv
·
24 Oct 2025
·
arxiv:2505.05416
ROC Analysis with Covariate Adjustment Using Neural Network Models: Evaluating the Role of Age in the Physical Activity-Mortality Association
arXiv
·
20 Oct 2025
·
arxiv:2510.14494
Glucodensity functional profiles outperform traditional continuous glucose monitoring metrics
Scientific Reports
·
29 Sep 2025
·
doi:10.1038/s41598-025-18119-2
Age, Sex, BMI, Meal Timing, and Glycemic Response to Meal Glycemic Load
JAMA Network Open
·
23 Sep 2025
·
doi:10.1001/jamanetworkopen.2025.33193
Continuous Temporal Learning of Probability Distributions via Neural ODEs with Applications in Continuous Glucose Monitoring Data
arXiv
·
18 Sep 2025
·
arxiv:2505.08698
Distributional Data Analysis Uncovers Hundreds of Novel and Heritable Phenomic Features from Temporal Cotton and Maize Drone Imagery
openRxiv
·
07 Sep 2025
·
doi:10.1101/2025.09.05.674557
Functional time transformation model with applications to digital health
Computational Statistics & Data Analysis
·
01 Jul 2025
·
doi:10.1016/j.csda.2025.108131
Model-Free Kernel Conformal Depth Measures Algorithm for Uncertainty Quantification in Regression Models in Separable Hilbert Spaces
arXiv
·
11 Jun 2025
·
arxiv:2506.08325
Conformal prediction for uncertainty quantification in dynamic biological systems
PLOS Computational Biology
·
12 May 2025
·
doi:10.1371/journal.pcbi.1013098
A Telehealth Program Using Continuous Glucose Monitoring and a Connected Insulin Pen Cap in Nursing Homes for Older Adults with Insulin-Treated Diabetes: The Trescasas Study
Diabetes Technology & Therapeutics
·
01 May 2025
·
doi:10.1089/dia.2024.0356
Uncertainty quantification for intervals
arXiv
·
01 Apr 2025
·
arxiv:2408.16381
Deep Learning Framework with Uncertainty Quantification for Survey Data: Assessing and Predicting Diabetes Mellitus Risk in the American Population
arXiv
·
27 Mar 2025
·
arXiv:2403.19752
Optimal Cut-Point Estimation for Functional Digital Biomarkers: Application to Diabetes Risk Stratification via Continuous Glucose Monitoring
arXiv
·
11 Mar 2025
·
arxiv:2404.09716
Causal survival embeddings: Non-parametric counterfactual inference under right-censoring
Statistical Methods in Medical Research
·
11 Feb 2025
·
doi:10.1177/09622802241311455
Kernel biclustering algorithm in Hilbert spaces
Advances in Data Analysis and Classification
·
21 Jan 2025
·
doi:10.1007/s11634-024-00619-0
Variable Selection Methods for Multivariate, Functional, and Complex Biomedical Data in the AI Age
arXiv
·
14 Jan 2025
·
arxiv:2501.06868
2024
Predicting distributions of physical activity profiles in the National Health and Nutrition Examination Survey database using a partially linear Fréchet single index model
Biostatistics
·
31 Dec 2024
·
doi:10.1093/biostatistics/kxaf013
Divergent hypoglycemic and hyperglycemic responses to the components of evening meals. A general adult population study in individuals without diabetes (AEGIS Study)
Clinical Nutrition
·
01 Dec 2024
·
doi:10.1016/j.clnu.2024.11.020
Exploring the Interplay Between Physical Activity, Dietary Patterns, Diabetes, and All-Cause Mortality in the U.S.A. Population, NHANES 2011-2014: A Distributional Data Analysis Perspective
Springer Science and Business Media LLC
·
15 Nov 2024
·
doi:10.21203/rs.3.rs-5314139/v1
Exploring the association between daily distributional patterns of physical activity and cardiovascular mortality risk among older adults in NHANES 2003-2006
Annals of Epidemiology
·
01 Nov 2024
·
doi:10.1016/j.annepidem.2024.10.001
Uncertainty Quantification in Dynamic Models of Biological Systems Using Conformal Prediction
[object Object]
·
01 Oct 2024
·
doi: 10.5281/zenodo.13838652
Book Review: Functional Data Analysis with R by Ciprian M. Crainiceanu, Jeff Goldsmith, Andrew Leroux, and Erjia Cui
Journal of Agricultural, Biological and Environmental Statistics
·
01 Oct 2024
·
doi:10.1007/s13253-024-00656-4
Multivariate scalar on multidimensional distribution regression with application to modeling the association between physical activity and cognitive functions
Biometrical Journal
·
22 Sep 2024
·
doi:10.1002/bimj.202400042
Neural interval-censored survival regression with feature selection
Statistical Analysis and Data Mining: The ASA Data Science Journal
·
16 Jul 2024
·
doi:10.1002/sam.11704
Energy Distance and Kernel Mean Embeddings for Two-Sample Survival Testing with Applications in Immunotherapy Clinical Trials
REVSTAT-Statistical Journal
·
14 Jun 2024
·
doi:10.57805/revstat.vi.572
Conformal uncertainty quantification using kernel depth measures in separable Hilbert spaces
arXiv
·
24 May 2024
·
arxiv:2405.13970
Uncertainty quantification in metric spaces
arXiv
·
09 May 2024
·
arxiv:2405.05110
Insulin glargine 300 U/ml versus insulin degludec 100 U/ml improves nocturnal glycaemic control and variability in type 1 diabetes under routine clinical practice: A glucodensities-based post hoc analysis of the OneCare study
Diabetes, Obesity and Metabolism
·
01 May 2024
·
doi: 10.1111/dom.15496
Insulin glargine 300 U/ml versus insulin degludec 100 U/ml improves nocturnal glycaemic control and variability in type 1 diabetes under routine clinical practice: A glucodensities-based post hoc analysis of the OneCare study
Diabetes, Obesity and Metabolism
·
20 Feb 2024
·
doi:10.1111/dom.15496
Author Correction: Reassessment of fluctuating dental asymmetry in Down syndrome
Scientific Reports
·
16 Jan 2024
·
doi:10.1038/s41598-024-51672-w
2021
Glucodensities: A new representation of glucose profiles using distributional data analysis
Statistical Methods in Medical Research
·
01 Jun 2021
·
doi: 10.1177/0962280221998064