Investigación
El futuro ya está en marcha
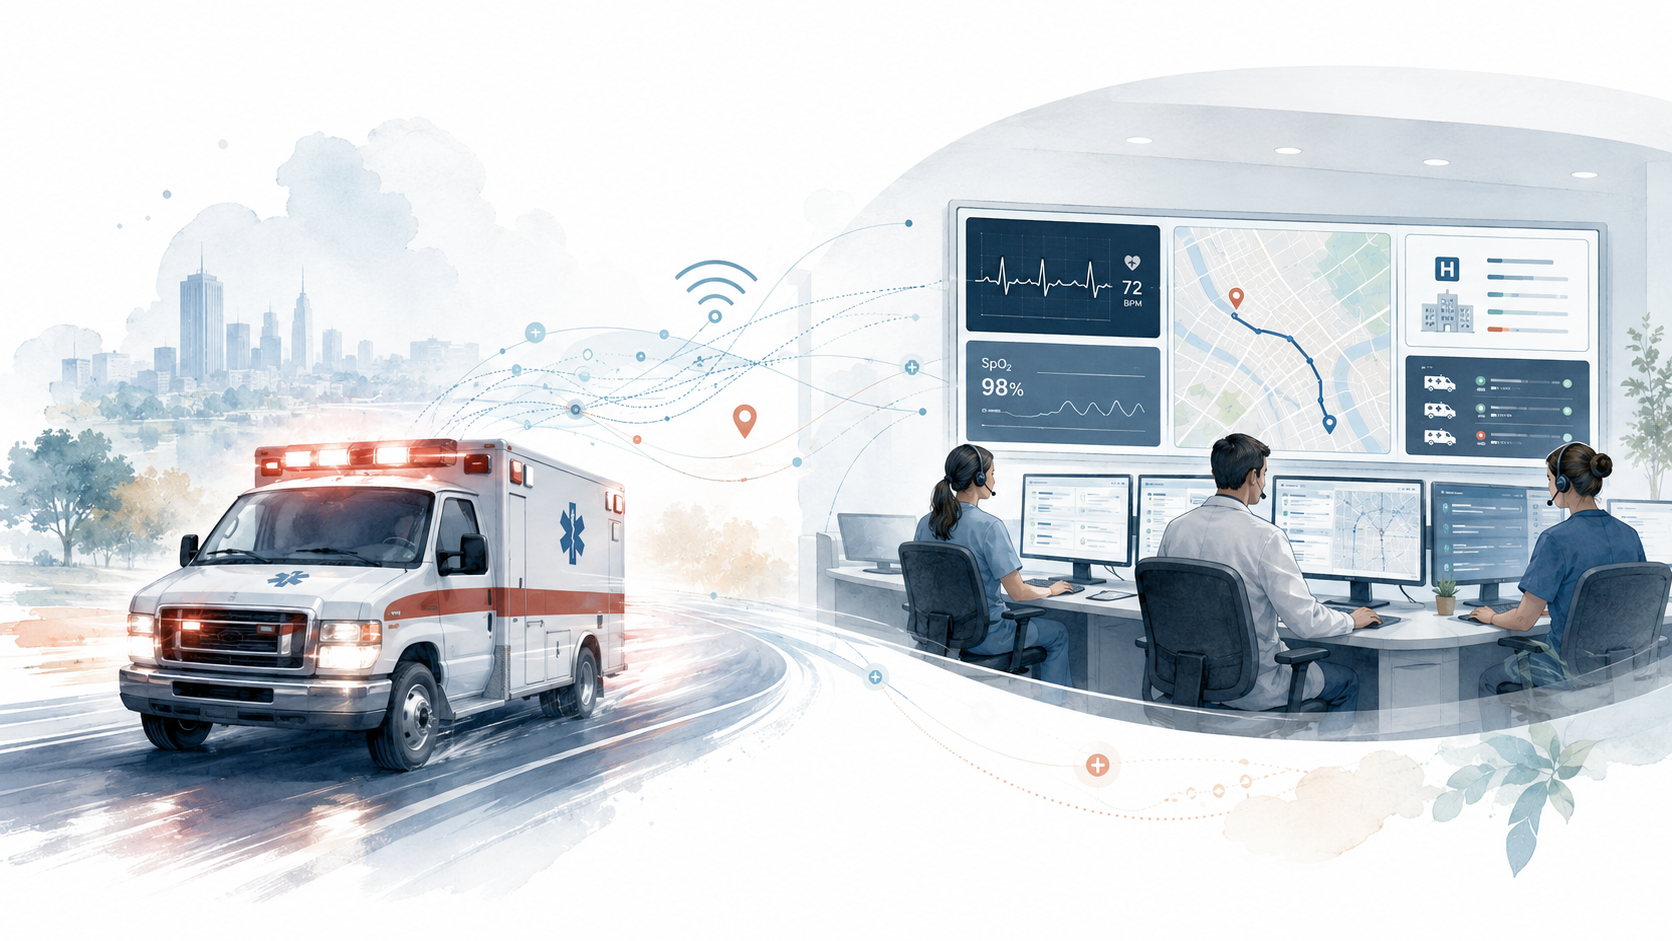
Imaginemos a una persona que sufre un síndrome coronario agudo mientras está sola en casa y lleva un dispositivo que monitoriza continuamente sus constantes vitales. Al detectar cambios críticos, como un electrocardiograma anómalo o una caída del nivel de oxígeno, el dispositivo activa automáticamente una respuesta de emergencia. En cuestión de segundos, el sistema localiza y moviliza la ambulancia disponible más cercana, adaptándose en tiempo real al tráfico y a la capacidad de los hospitales.
Durante el traslado, el dispositivo transmite continuamente información vital del paciente, lo que permite ajustar de forma dinámica las decisiones clínicas y logísticas. Si el estado del paciente empeora, se avisa al hospital para que prepare una unidad de cuidados críticos. A su llegada, los modelos predictivos orientan las decisiones para lograr el mejor resultado posible y utilizar los recursos sanitarios con la máxima eficiencia.
Nuestra misión y visión
Nuestro objetivo a largo plazo es construir un marco de toma de decisiones sanitarias que mejore las decisiones clínicas y de salud pública, tanto individuales como poblacionales, combinando bioestadística, tecnologías de salud digital e investigación operativa.
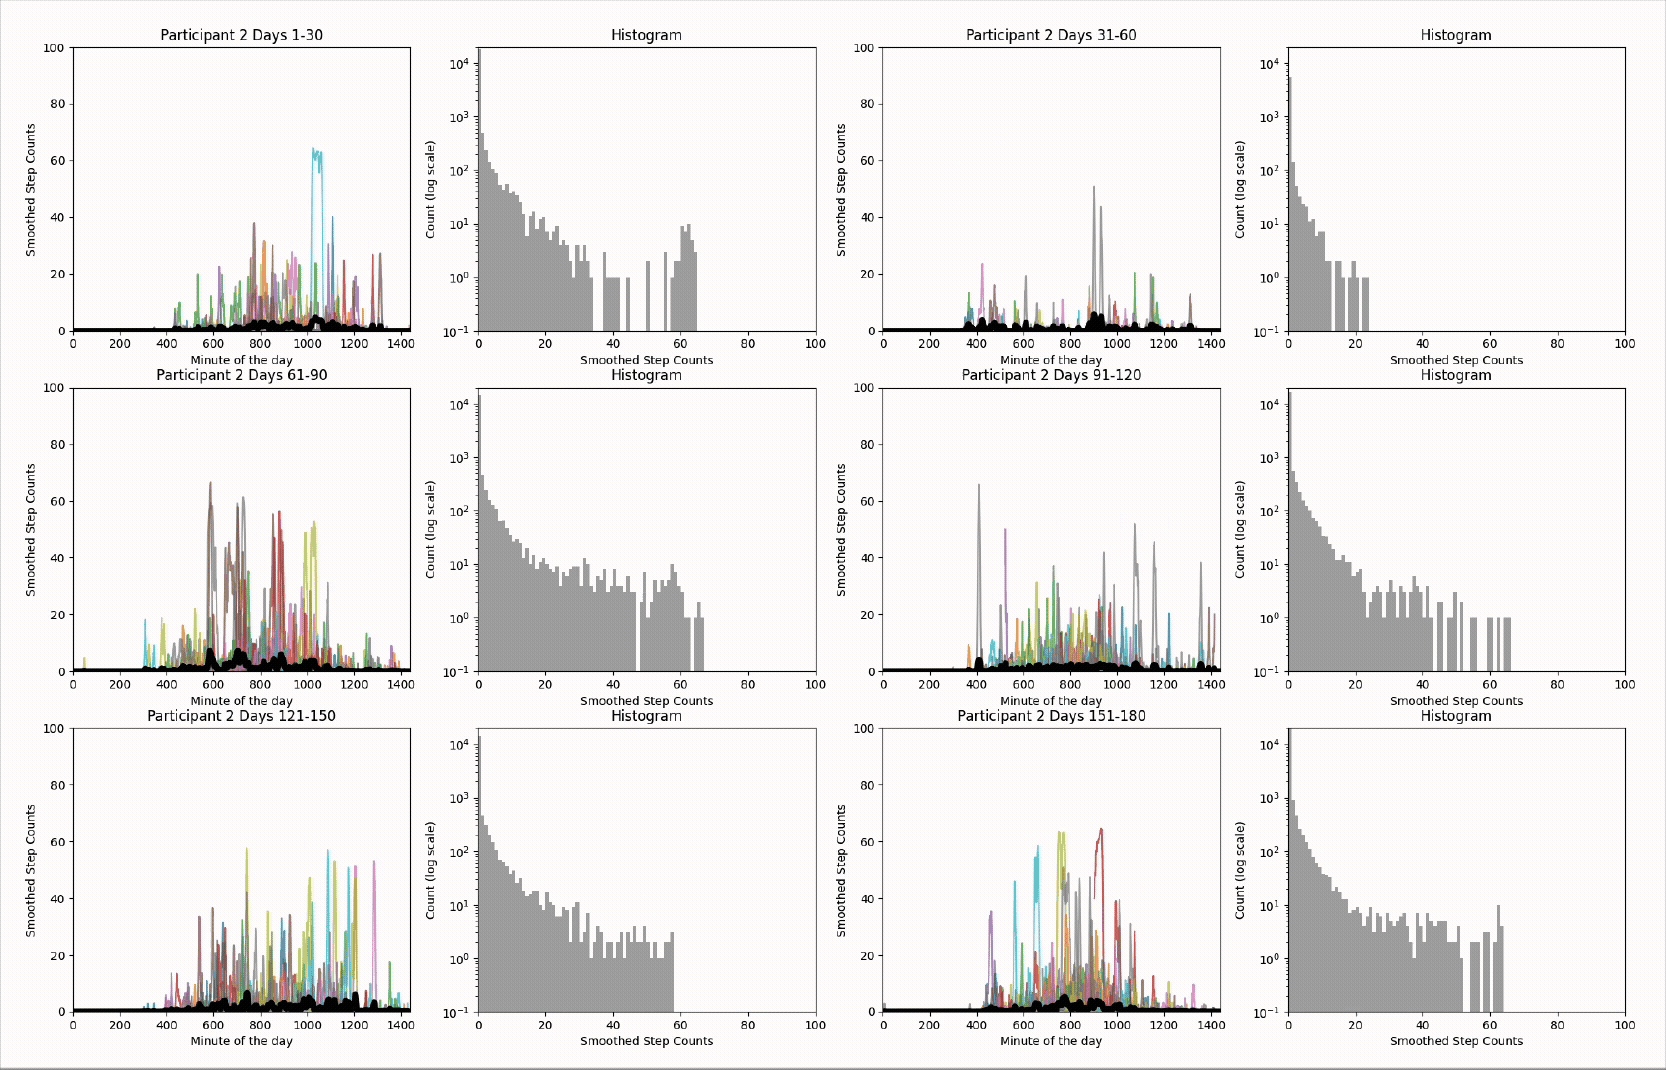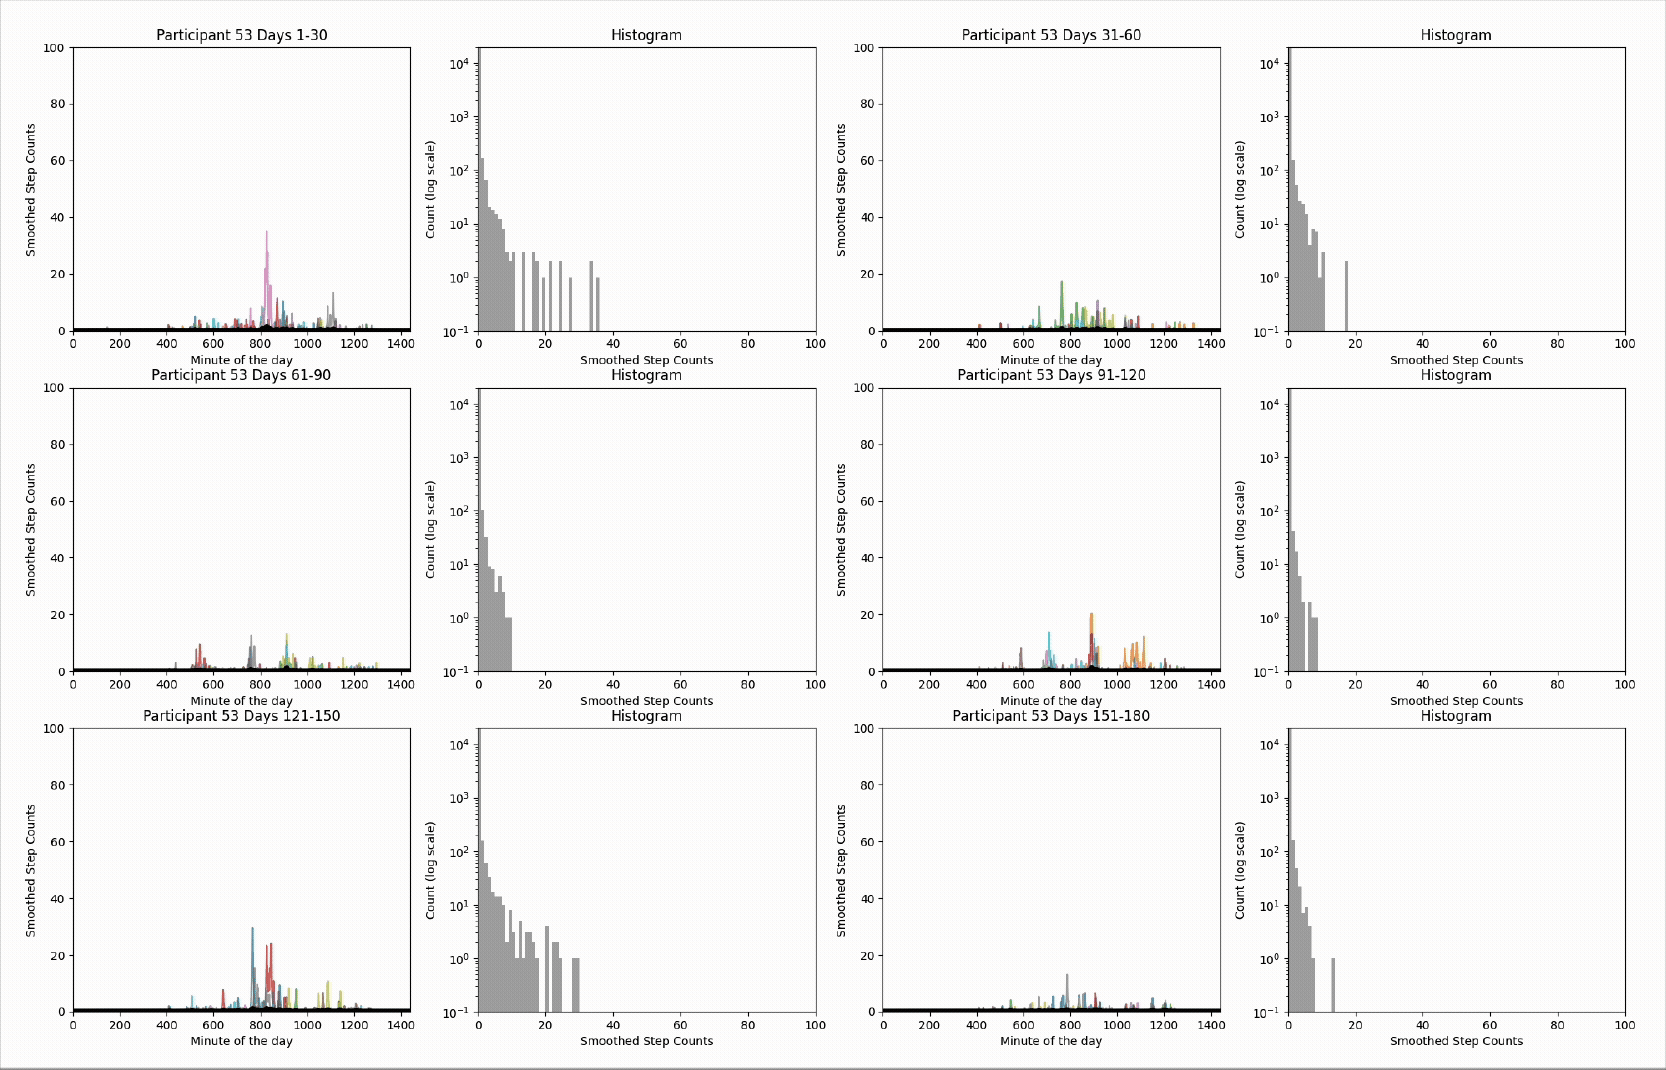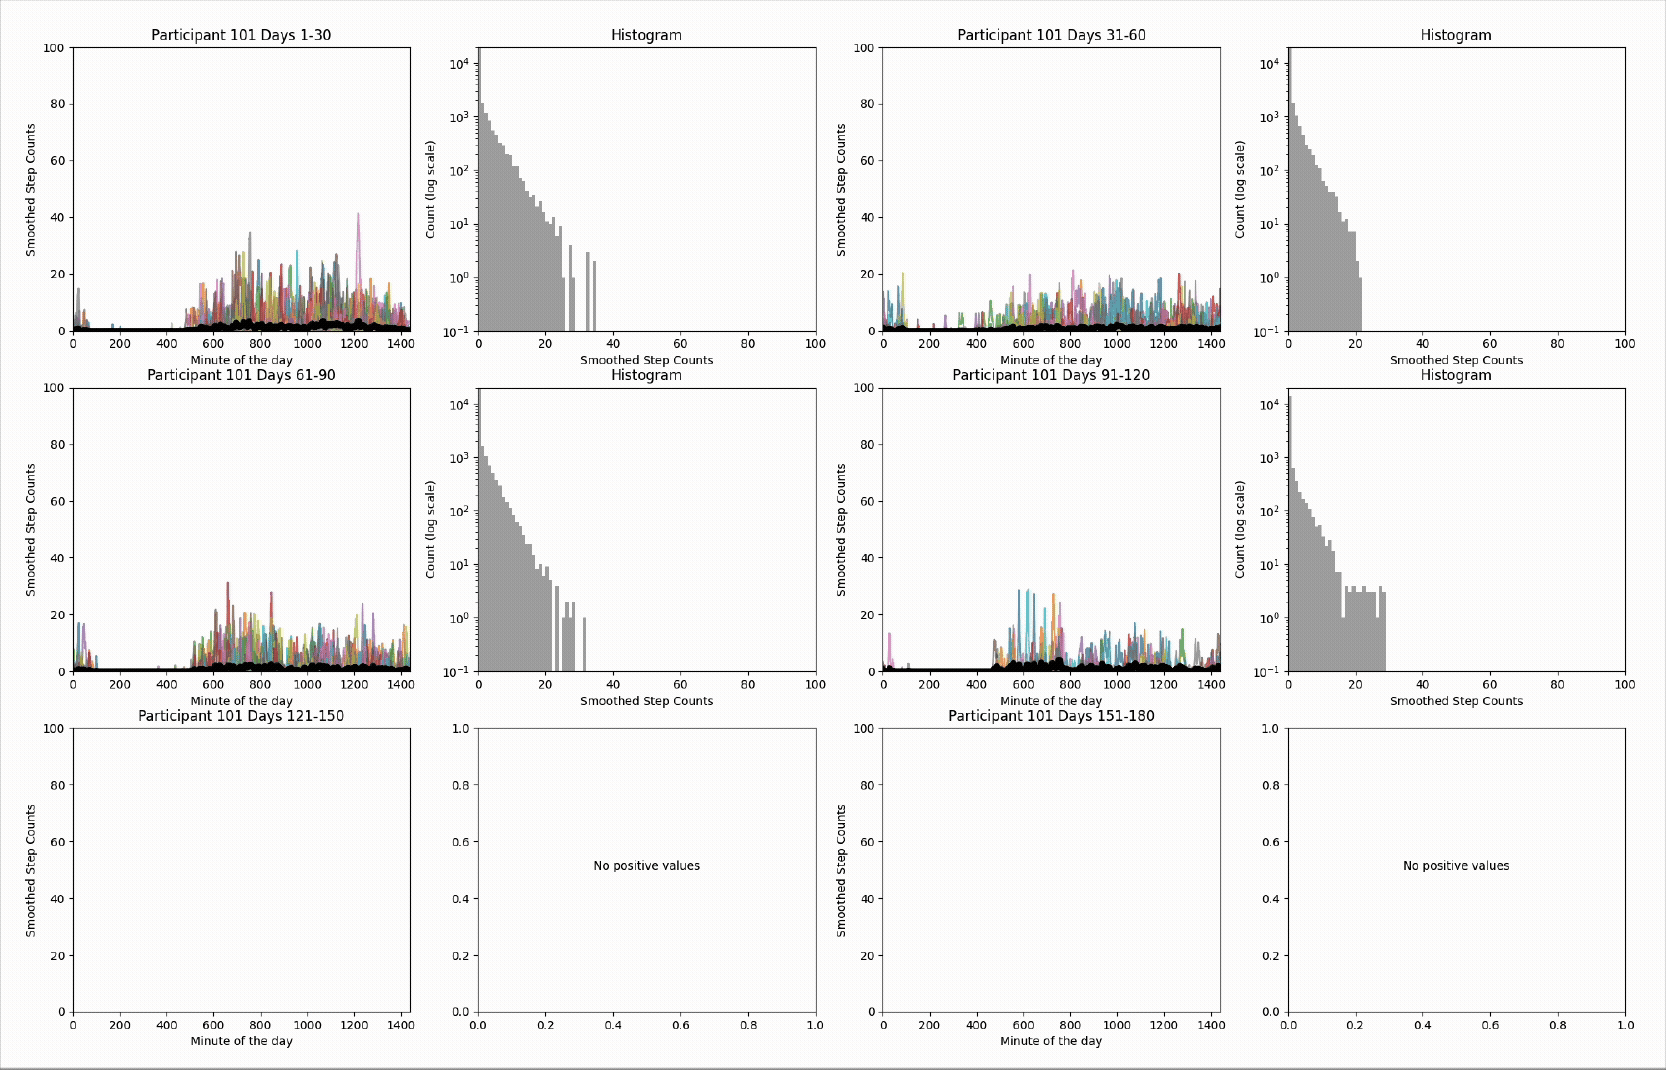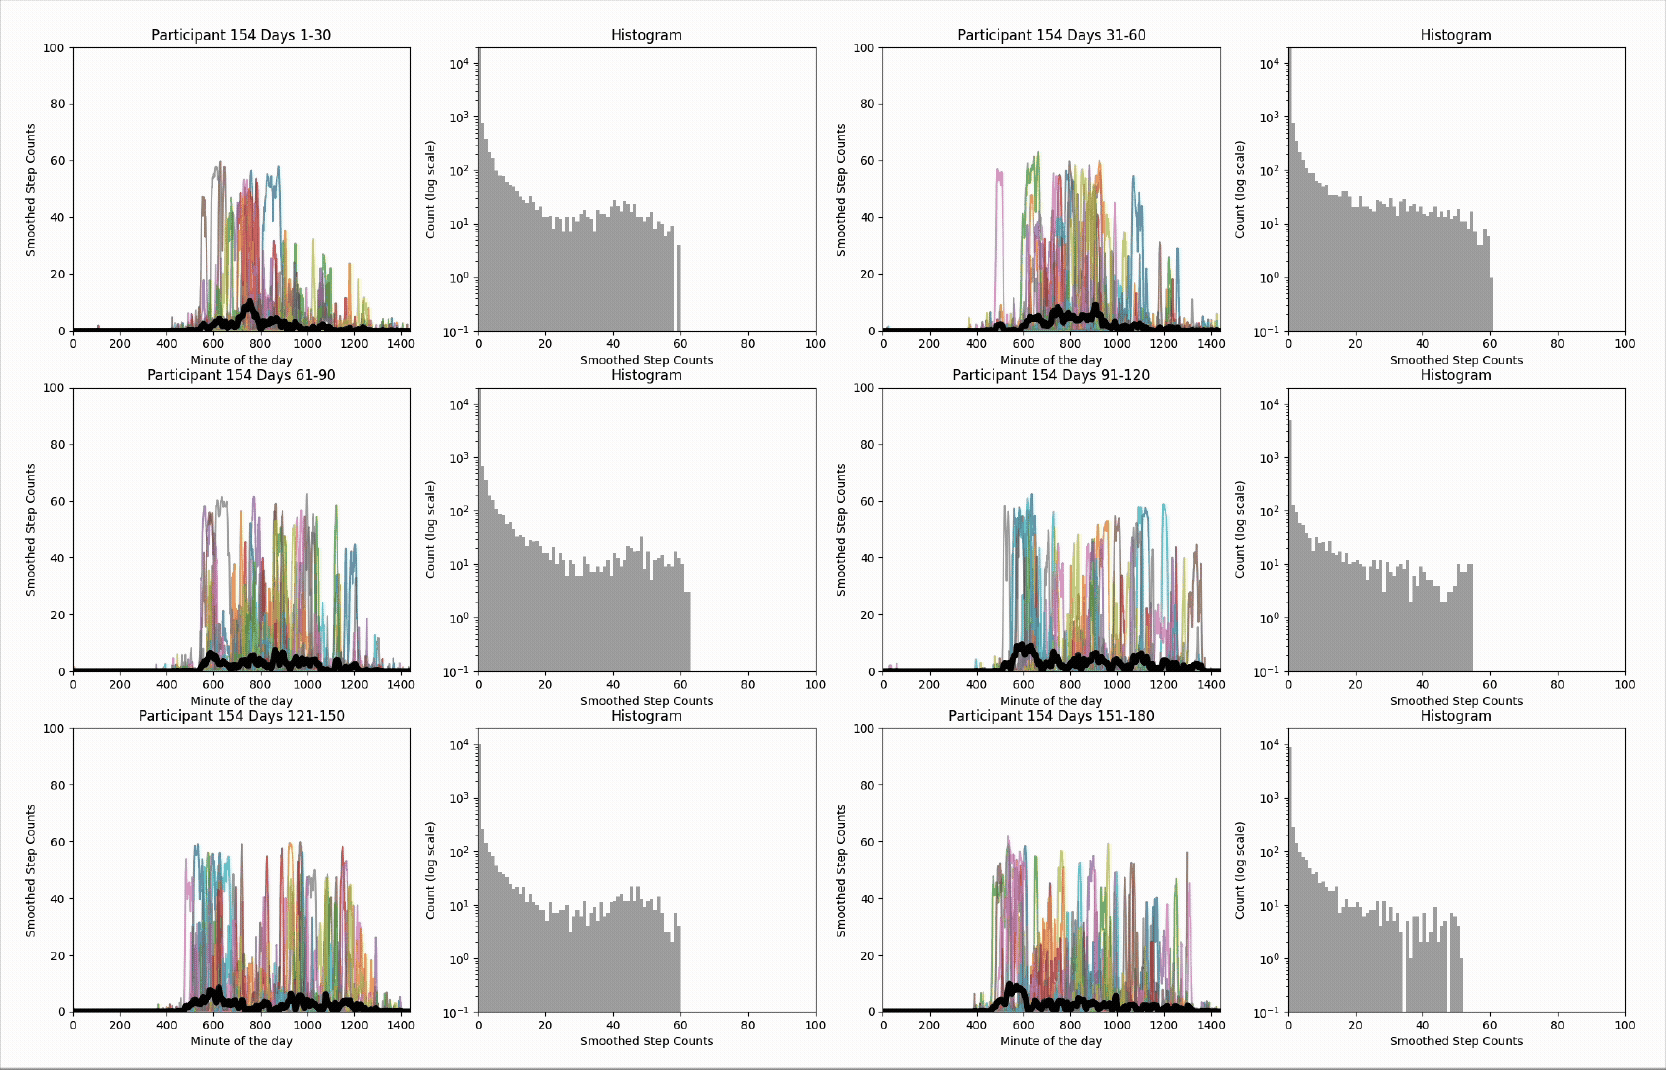
Actualmente desarrollamos métodos estadísticos y de inteligencia artificial para problemas clínicos complejos que implican datos de salud continuos, de alta frecuencia y en tiempo real. Queremos que estos métodos respondan a las preguntas médicas actuales y ayuden a identificar las más importantes. ¿Qué dieta es la mejor para una persona concreta? ¿Cuánta actividad física necesita para favorecer un envejecimiento saludable y la longevidad? ¿Cómo deben cambiar estas recomendaciones según su perfil clínico, su biología, su entorno y su estilo de vida?
Para responder a estas preguntas, nuestra investigación combina métodos modernos de IA estadística para inferencia causal, análisis de supervivencia, cuantificación de la incertidumbre y modelización generativa con efectos aleatorios, con el fin de avanzar en el aprendizaje estadístico para objetos aleatorios no euclídeos. El diseño cuidadoso de los estudios y la escalabilidad computacional son esenciales. Buscamos métodos matemáticamente rigurosos y eficientes a escala poblacional, orientados a recursos biomédicos como UK Biobank, All of Us Research Program, Human Phenotype Project y NHANES.
Aunque muchos métodos publicados en revistas metodológicas de primer nivel son matemáticamente rigurosos y técnicamente sólidos, no siempre se diseñan teniendo en cuenta la complejidad de los datos clínicos reales y los supuestos necesarios para analizarlos. Por ello, partimos de preguntas biomédicas concretas y desafíos prácticos. Desarrollamos métodos que reflejen la estructura de los datos, la realidad de la práctica clínica y las decisiones críticas de pacientes, profesionales y sistemas sanitarios para hacer avanzar el campo.
Siete pilares de nuestro programa de investigación en salud digital
Nuestros siete artículos representan un avance metodológico y conceptual sustancial para la salud digital.
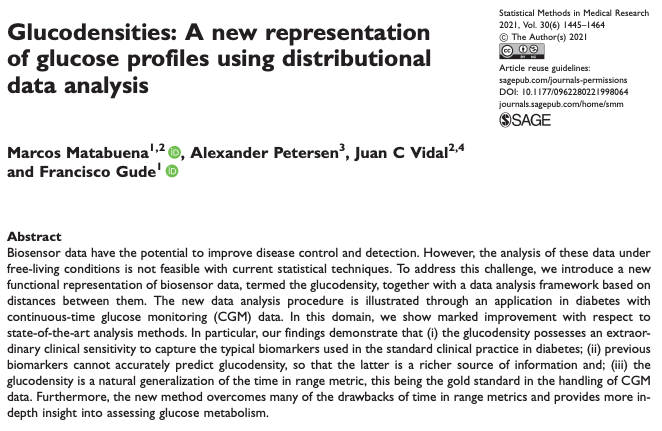
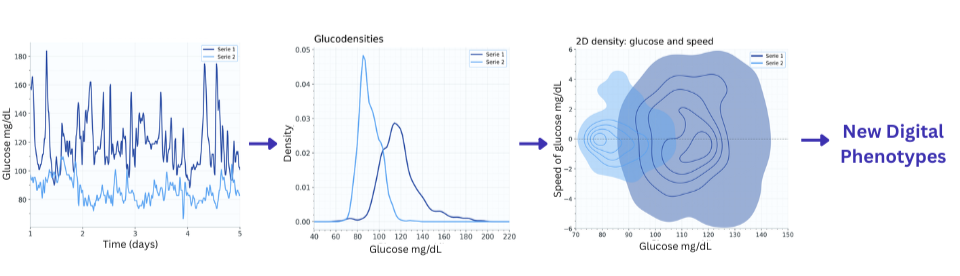
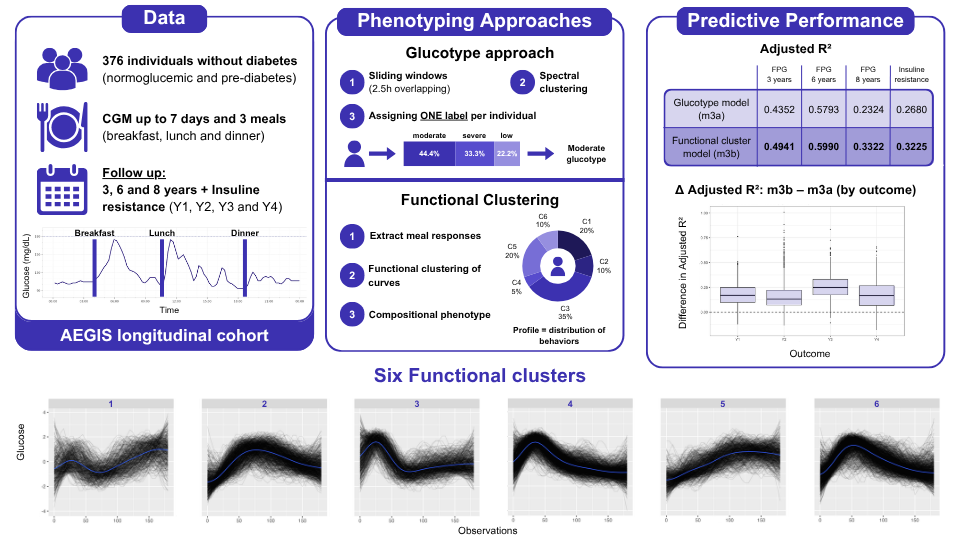
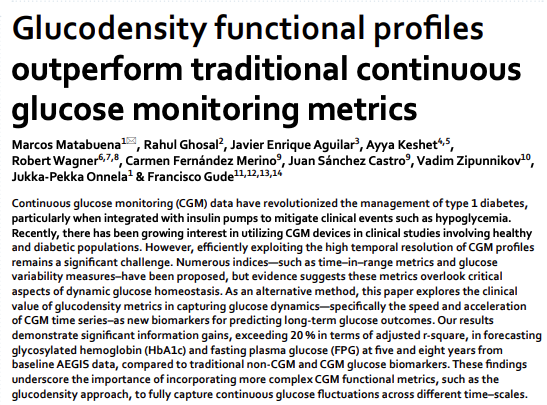
La introducción de la glucodensidad constituye un primer paso hacia fenotipos digitales más complejos mediante el análisis de datos funcionales y distribucionales. Este marco abre nuevas vías de descubrimiento biológico y permite aprovechar con mayor eficiencia la información continua de los nuevos dispositivos médicos, en lugar de reducirla a unas pocas medidas escalares.
La glucodensidad multivariante supone un nuevo avance conceptual en el análisis de la fisiología humana. Los datos clínicos dejan de analizarse únicamente como números individuales y pasan a tratarse como objetos complejos, más próximos a las imágenes médicas. Ahora podemos integrar la dinámica de los procesos fisiológicos subyacentes en un marco distribucional unificado de glucodensidad.
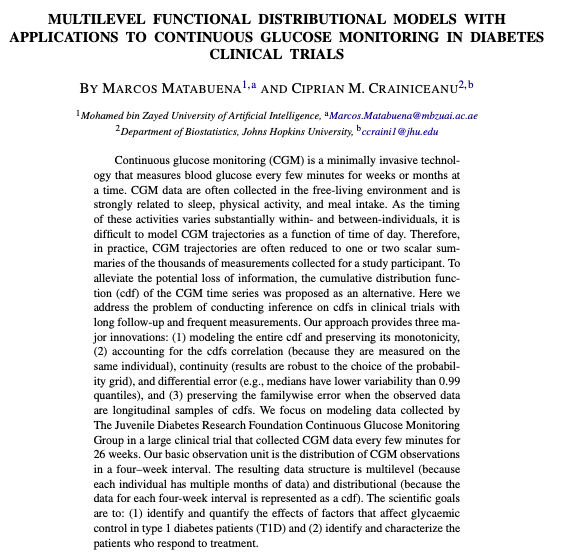
El trabajo conjunto con Ciprian Crainiceanu sobre modelos de efectos aleatorios para datos de glucodensidad extiende estas ideas a estudios longitudinales de semanas, meses o años. Este trabajo crea un nuevo marco para utilizar información digital en ensayos clínicos, con la posibilidad de aumentar la potencia estadística y descubrir biomarcadores longitudinales nuevos y más relevantes.
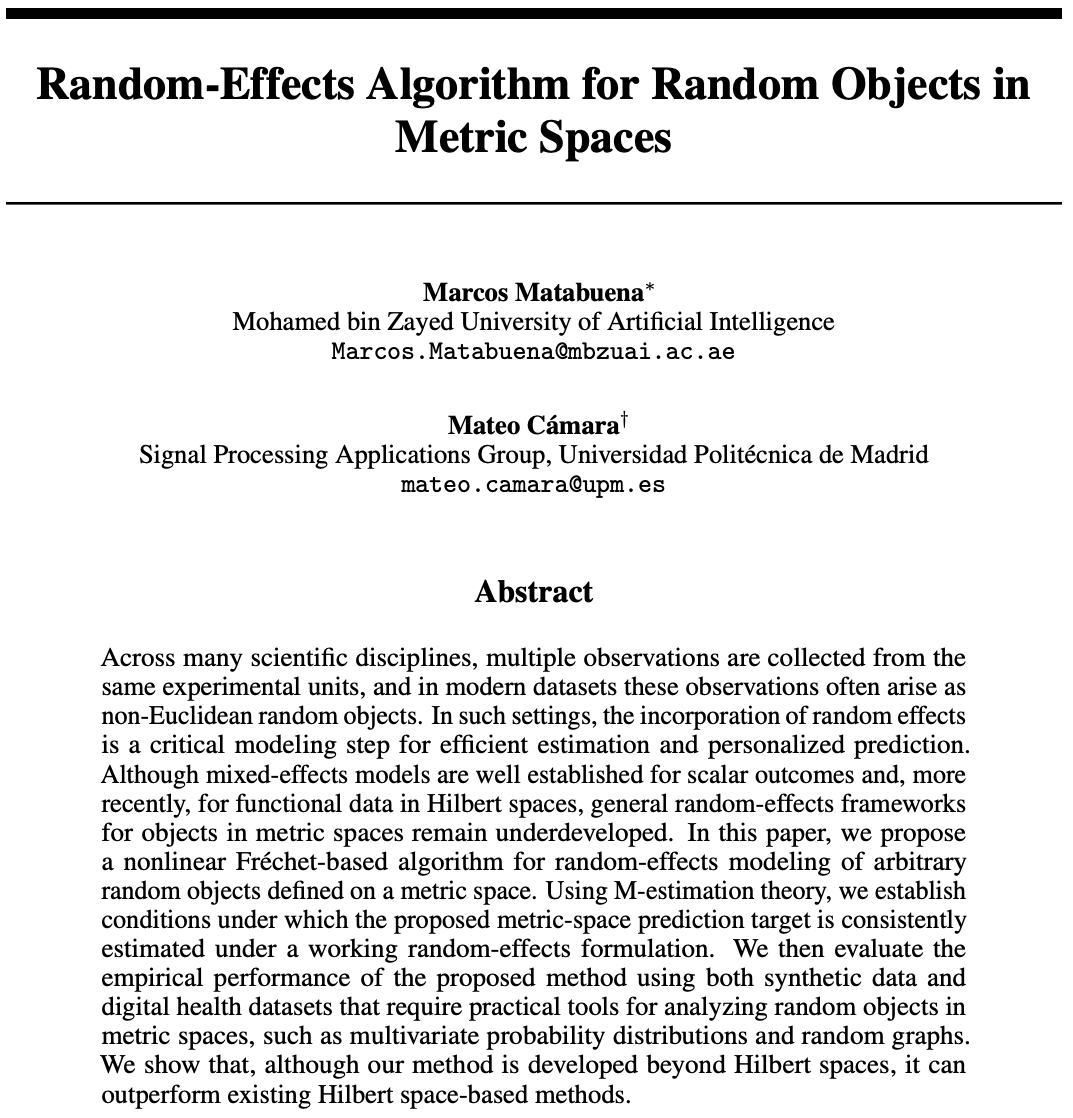
Junto con Mateo Cámara, proponemos el primer marco de modelización con efectos aleatorios en espacios métricos generales, que ofrece un enfoque unificado para analizar distintos tipos de objetos estadísticos en estudios clínicos. La mayor parte de la información de salud digital es casi continua en el tiempo, se mide en múltiples escalas temporales y presenta una estructura multinivel. Nuestro marco ofrece, por primera vez, una vía analítica general para modelar estas fuentes complejas de variación con mayor generalidad matemática.
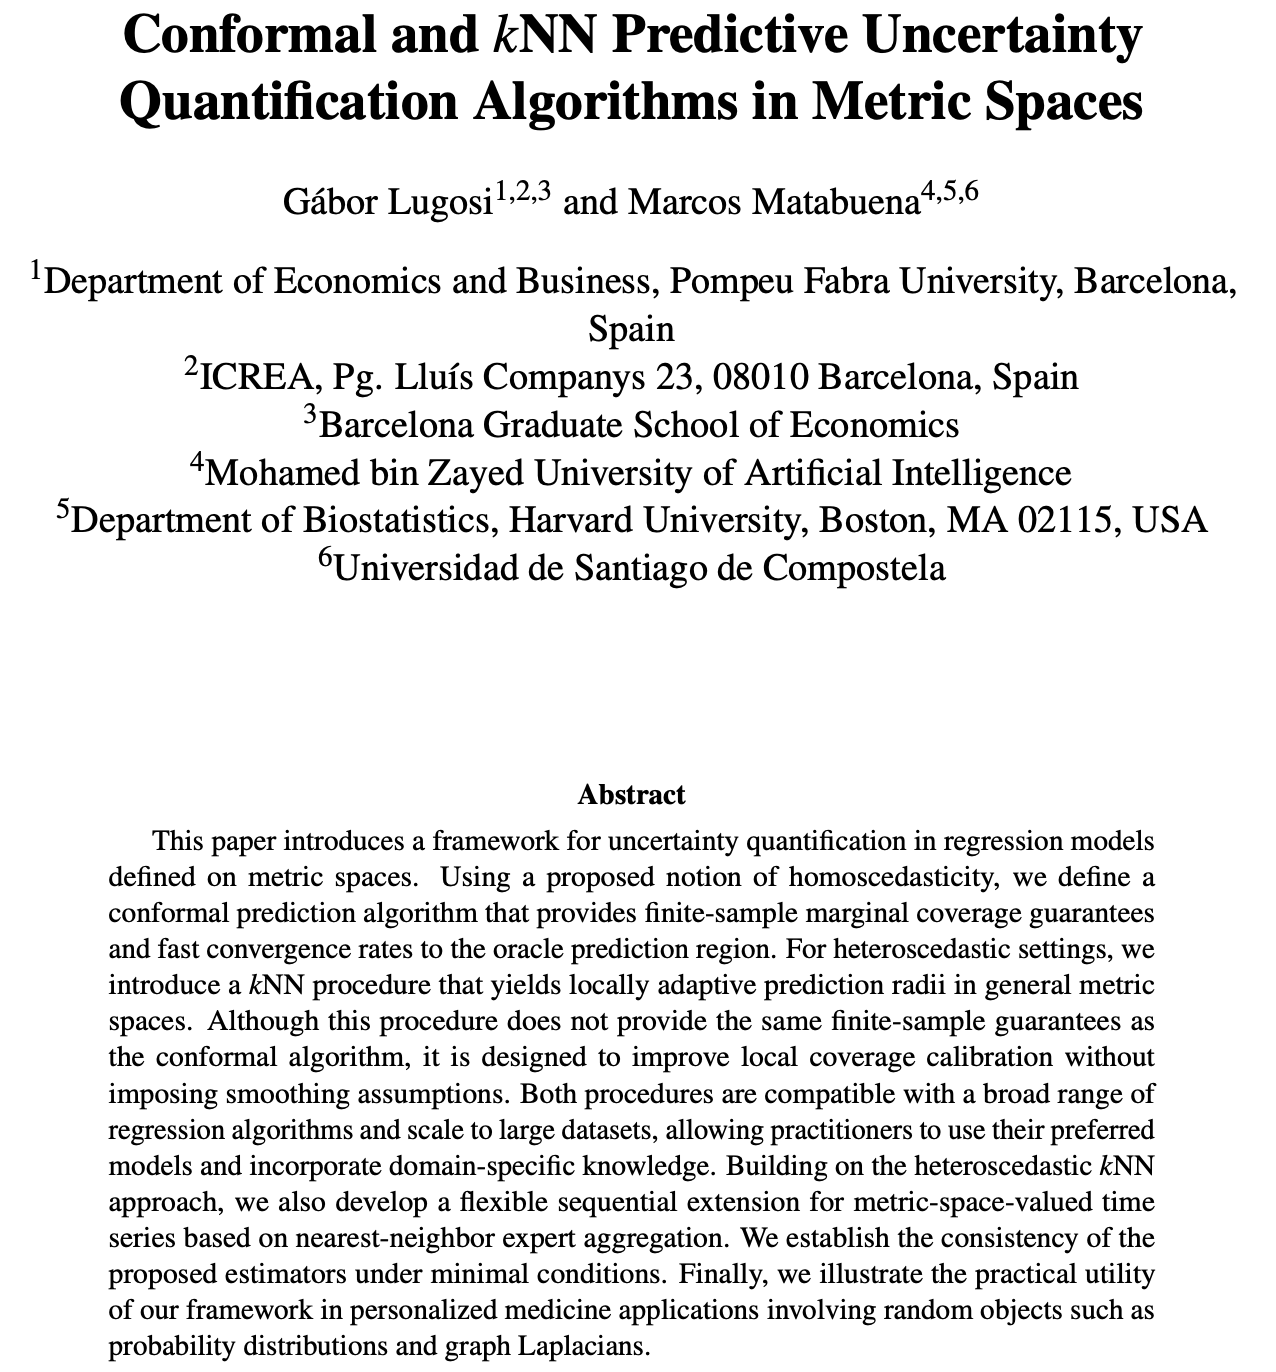
El marco de cuantificación de la incertidumbre en espacios métricos, desarrollado junto con Gábor Lugosi, es metodológicamente importante porque permite calibrar y evaluar formalmente la cobertura condicional sin condiciones restrictivas de suavidad. También abre un marco más general para cuantificar la incertidumbre de los biomarcadores del futuro, que se representarán cada vez más mediante distribuciones, funciones, imágenes, redes u otros objetos aleatorios no euclídeos complejos.
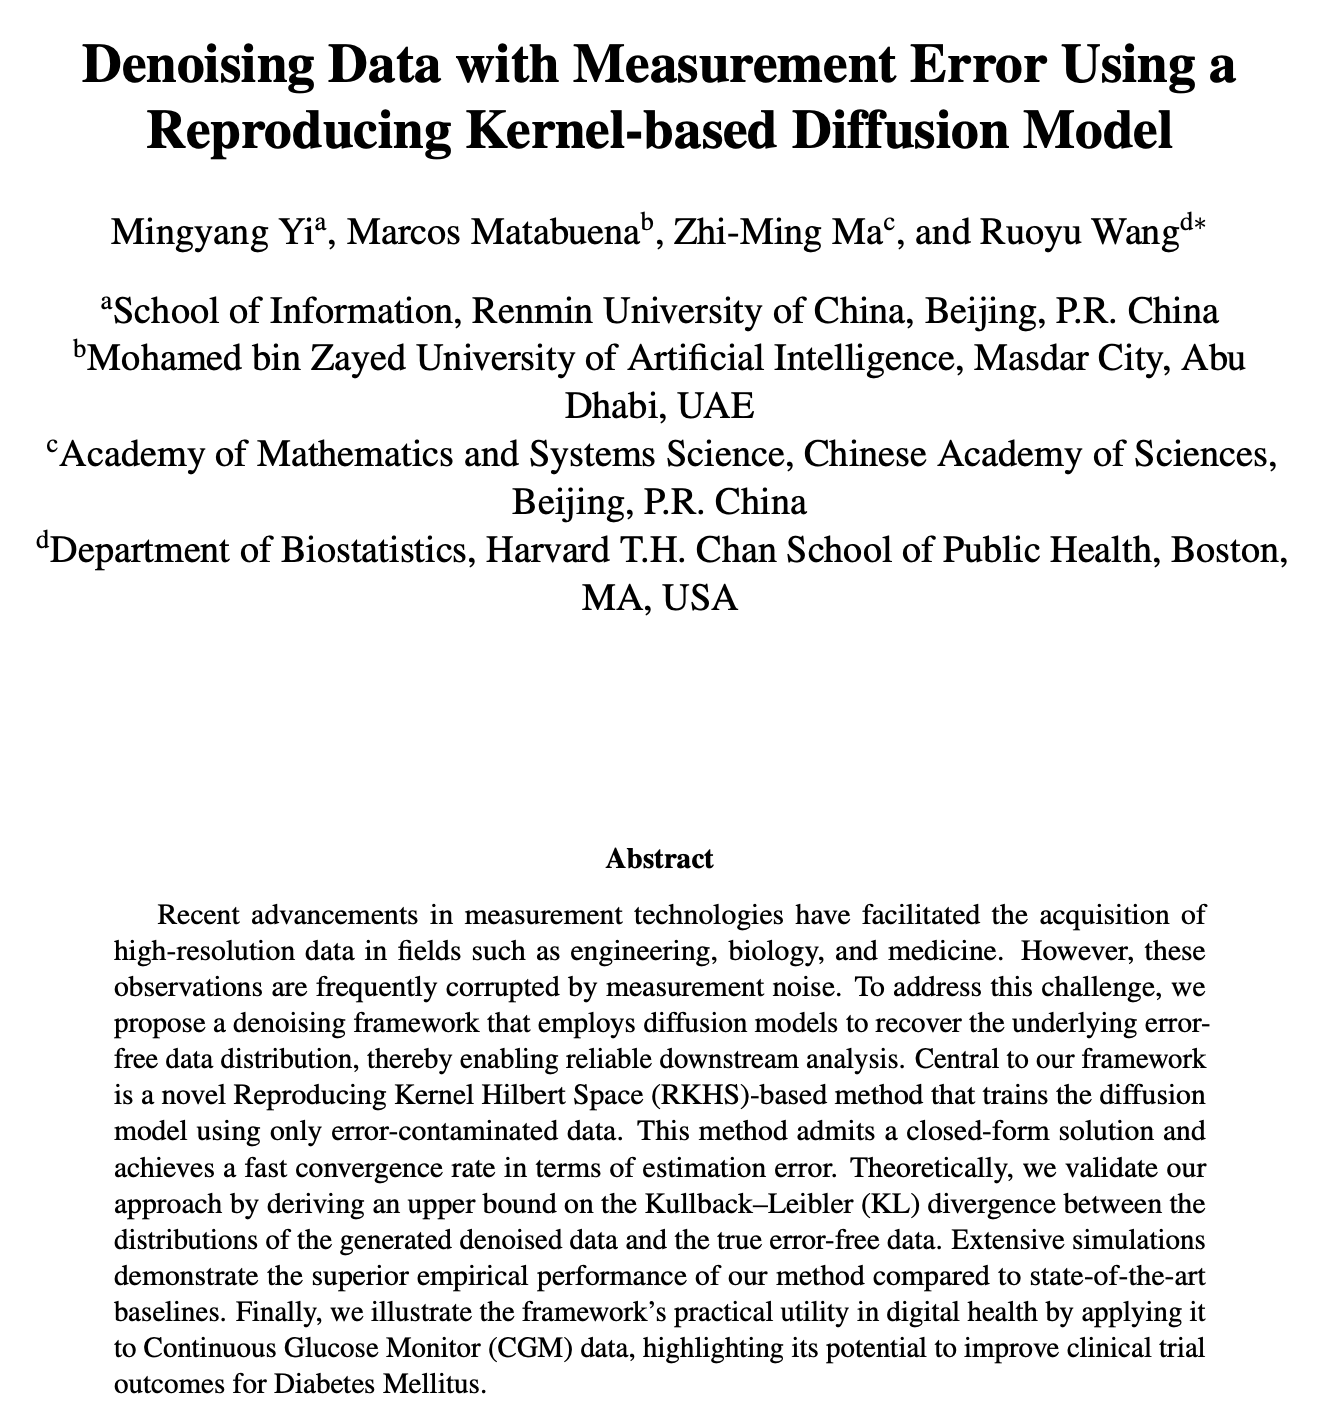
El trabajo con mis colegas chinos, Mingyang Yi, Zhiming Ma, y Ruoyu Wang, sobre modelos de difusión y error de medición permite incorporar la incertidumbre de las mediciones a las decisiones biomédicas. La idea principal es integrar métodos generales de IA generativa en los procedimientos estadísticos clásicos de error de medición, para que los errores de sensores, mediciones clínicas y otras tecnologías biomédicas se incorporen directamente al análisis.
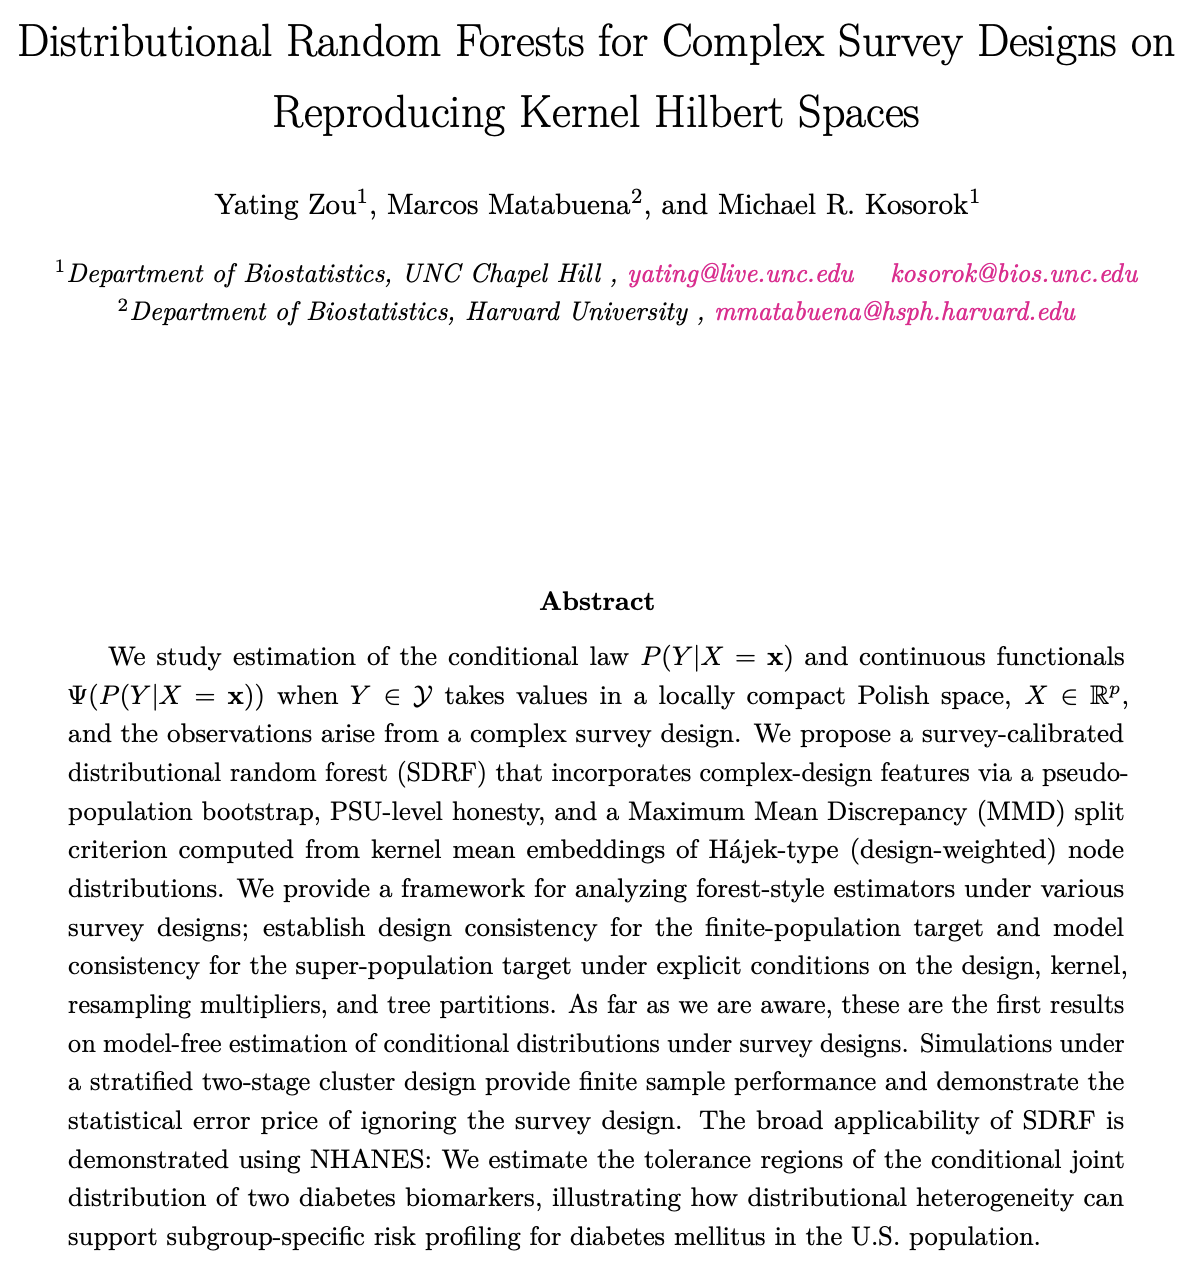
Por último, el éxito de la nueva era de los datos también dependerá de nuevos diseños experimentales y de muestreo. En colaboración con Yating Zou y Michael Kosorok, proponemos una nueva metodología de bosques aleatorios para datos de encuestas complejas. El método tiene implicaciones relevantes para la inferencia, ya que aplica el procedimiento bootstrap a nivel de nodo. Esto abre oportunidades teóricas para mejorar el aprendizaje automático en diseños de muestreo complejos y, a la vez, ofrece una forma fundamentada de utilizar grandes bases de datos de salud preservando una inferencia válida para la población objetivo.
En conjunto, estos trabajos definen los pilares de nuestro programa: nuevas representaciones de datos de salud digital, modelización longitudinal y multinivel, cuantificación de la incertidumbre, corrección del error de medición mediante IA generativa e inferencia estadísticamente válida en estudios biomédicos complejos.
Publicaciones de años anteriores
2026
Denoising Data with Measurement Error Using a Reproducing Kernel-based Diffusion Model
arXiv
·
14 Jul 2026
·
arxiv:2501.00212
EpiBinder: a multimodal framework for cell-type-specific prediction and interpretation of transcription factor binding
openRxiv
·
08 Jul 2026
·
10.64898/2026.07.06.736502
Pre-activity glycemic prediction prioritizes post-meal movement
openRxiv
·
24 Jun 2026
·
doi:10.64898/2026.06.22.26356272
Conformal and kNN Predictive Uncertainty Quantification Algorithms in Metric Spaces
arXiv
·
23 Jun 2026
·
arxiv:2507.15741
A Deep Learning-Based Predictive Algorithm for Metabolic Syndrome Detection in the U.S. Population
openRxiv
·
02 Jun 2026
·
doi:10.64898/2026.05.24.26354007
Capturing the Curve: Functional Data Analysis for Validated Digital Outcome Measures
arXiv
·
28 May 2026
·
arxiv:2605.28344
Gaussian mixture models in Hilbert spaces via kernel methods
arXiv
·
08 May 2026
·
arxiv:2605.05996
Screening for diabetes mellitus in the US population using neural network-based modeling and complex survey designs
Statistical Methods in Medical Research
·
07 May 2026
·
doi:10.1177/09622802261442893
Random-Effects Algorithm for Random Objects in Metric Spaces
arXiv
·
05 May 2026
·
arxiv:2605.02693
Continuous-Time Learning of Probability Distributions: A Case Study in a Digital Trial of Young Children with Type 1 Diabetes
arXiv
·
26 Mar 2026
·
arxiv:2603.24427
Multilevel functional distributional models with applications to continuous glucose monitoring in diabetes clinical trials
The Annals of Applied Statistics
·
01 Mar 2026
·
doi:10.1214/26-AOAS2139
Glucodensity-Based Models Outperform Time in Range and Glycemia Risk Index in Prediction Models
Journal of Diabetes Science and Technology
·
23 Feb 2026
·
doi:10.1177/19322968261421954
Survival on Image Regression With Application to Partially Functional Distributional Representation of Physical Activity
Statistical Analysis and Data Mining: An ASA Data Science Journal
·
01 Feb 2026
·
doi:10.1002/sam.70068
Exploratory analysis of smartphone-based step counts as a digital biomarker for survival in ALS patients
Frontiers in Digital Health
·
29 Jan 2026
·
doi:10.3389/fdgth.2025.1705368
Beyond scalar metrics: functional data analysis of postprandial continuous glucose monitoring in the AEGIS study
BMC Medical Research Methodology
·
24 Jan 2026
·
doi:10.1186/s12874-025-02748-2
Distributional Random Forests for Complex Survey Designs on Reproducing Kernel Hilbert Spaces
arXiv
·
07 Jan 2026
·
arxiv:2512.08179
Daily Physical Activity Patterns Enhance Mortality Prediction in NHANES 2011-2014: A Comparative Study Across Classical, Machine Learning, and Deep Learning Models Using Accelerometer Data
Journal for the Measurement of Physical Behaviour
·
01 Jan 2026
·
doi:10.1123/jmpb.2025-0052
From Physical Activity to Spirometry (as a Curve): A Combined Model for Mortality Prediction
Sin publicar
·
01 Jan 2026
·
doi:10.13140/RG.2.2.35806.60486
2025
Continuous Glucose Monitoring as an alternative for Cystic Fibrosis Related diabetes screening and diagnosis
Diabetes Research and Clinical Practice
·
01 Nov 2025
·
doi:10.1016/j.diabres.2025.112952
Unequal strides to longevity. The extra mile to health equity
Annals of Epidemiology
·
01 Nov 2025
·
doi:10.1016/j.annepidem.2025.10.009
kNN Algorithm for Conditional Mean and Variance Estimation with Automated Uncertainty Quantification and Variable Selection
arXiv
·
28 Oct 2025
·
arxiv:2402.01635
Variable Selection for Fixed and Random Effects in Multilevel Functional Mixed Effects Models
arXiv
·
24 Oct 2025
·
arxiv:2505.05416
ROC Analysis with Covariate Adjustment Using Neural Network Models: Evaluating the Role of Age in the Physical Activity-Mortality Association
arXiv
·
20 Oct 2025
·
arxiv:2510.14494
Glucodensity functional profiles outperform traditional continuous glucose monitoring metrics
Scientific Reports
·
29 Sep 2025
·
doi:10.1038/s41598-025-18119-2
Age, Sex, BMI, Meal Timing, and Glycemic Response to Meal Glycemic Load
JAMA Network Open
·
23 Sep 2025
·
doi:10.1001/jamanetworkopen.2025.33193
Continuous Temporal Learning of Probability Distributions via Neural ODEs with Applications in Continuous Glucose Monitoring Data
arXiv
·
18 Sep 2025
·
arxiv:2505.08698
Distributional Data Analysis Uncovers Hundreds of Novel and Heritable Phenomic Features from Temporal Cotton and Maize Drone Imagery
openRxiv
·
07 Sep 2025
·
doi:10.1101/2025.09.05.674557
Functional time transformation model with applications to digital health
Computational Statistics & Data Analysis
·
01 Jul 2025
·
doi:10.1016/j.csda.2025.108131
Model-Free Kernel Conformal Depth Measures Algorithm for Uncertainty Quantification in Regression Models in Separable Hilbert Spaces
arXiv
·
11 Jun 2025
·
arxiv:2506.08325
Conformal prediction for uncertainty quantification in dynamic biological systems
PLOS Computational Biology
·
12 May 2025
·
doi:10.1371/journal.pcbi.1013098
A Telehealth Program Using Continuous Glucose Monitoring and a Connected Insulin Pen Cap in Nursing Homes for Older Adults with Insulin-Treated Diabetes: The Trescasas Study
Diabetes Technology & Therapeutics
·
01 May 2025
·
doi:10.1089/dia.2024.0356
Uncertainty quantification for intervals
arXiv
·
01 Apr 2025
·
arxiv:2408.16381
Deep Learning Framework with Uncertainty Quantification for Survey Data: Assessing and Predicting Diabetes Mellitus Risk in the American Population
arXiv
·
27 Mar 2025
·
arXiv:2403.19752
Optimal Cut-Point Estimation for Functional Digital Biomarkers: Application to Diabetes Risk Stratification via Continuous Glucose Monitoring
arXiv
·
11 Mar 2025
·
arxiv:2404.09716
Causal survival embeddings: Non-parametric counterfactual inference under right-censoring
Statistical Methods in Medical Research
·
11 Feb 2025
·
doi:10.1177/09622802241311455
Kernel biclustering algorithm in Hilbert spaces
Advances in Data Analysis and Classification
·
21 Jan 2025
·
doi:10.1007/s11634-024-00619-0
Variable Selection Methods for Multivariate, Functional, and Complex Biomedical Data in the AI Age
arXiv
·
14 Jan 2025
·
arxiv:2501.06868
2024
Predicting distributions of physical activity profiles in the National Health and Nutrition Examination Survey database using a partially linear Fréchet single index model
Biostatistics
·
31 Dec 2024
·
doi:10.1093/biostatistics/kxaf013
Divergent hypoglycemic and hyperglycemic responses to the components of evening meals. A general adult population study in individuals without diabetes (AEGIS Study)
Clinical Nutrition
·
01 Dec 2024
·
doi:10.1016/j.clnu.2024.11.020
Exploring the Interplay Between Physical Activity, Dietary Patterns, Diabetes, and All-Cause Mortality in the U.S.A. Population, NHANES 2011-2014: A Distributional Data Analysis Perspective
Springer Science and Business Media LLC
·
15 Nov 2024
·
doi:10.21203/rs.3.rs-5314139/v1
Exploring the association between daily distributional patterns of physical activity and cardiovascular mortality risk among older adults in NHANES 2003-2006
Annals of Epidemiology
·
01 Nov 2024
·
doi:10.1016/j.annepidem.2024.10.001
Uncertainty Quantification in Dynamic Models of Biological Systems Using Conformal Prediction
[object Object]
·
01 Oct 2024
·
doi: 10.5281/zenodo.13838652
Book Review: Functional Data Analysis with R by Ciprian M. Crainiceanu, Jeff Goldsmith, Andrew Leroux, and Erjia Cui
Journal of Agricultural, Biological and Environmental Statistics
·
01 Oct 2024
·
doi:10.1007/s13253-024-00656-4
Multivariate scalar on multidimensional distribution regression with application to modeling the association between physical activity and cognitive functions
Biometrical Journal
·
22 Sep 2024
·
doi:10.1002/bimj.202400042
Neural interval-censored survival regression with feature selection
Statistical Analysis and Data Mining: The ASA Data Science Journal
·
16 Jul 2024
·
doi:10.1002/sam.11704
Energy Distance and Kernel Mean Embeddings for Two-Sample Survival Testing with Applications in Immunotherapy Clinical Trials
REVSTAT-Statistical Journal
·
14 Jun 2024
·
doi:10.57805/revstat.vi.572
Conformal uncertainty quantification using kernel depth measures in separable Hilbert spaces
arXiv
·
24 May 2024
·
arxiv:2405.13970
Uncertainty quantification in metric spaces
arXiv
·
09 May 2024
·
arxiv:2405.05110
Insulin glargine 300 U/ml versus insulin degludec 100 U/ml improves nocturnal glycaemic control and variability in type 1 diabetes under routine clinical practice: A glucodensities-based post hoc analysis of the OneCare study
Diabetes, Obesity and Metabolism
·
01 May 2024
·
doi: 10.1111/dom.15496
Insulin glargine 300 U/ml versus insulin degludec 100 U/ml improves nocturnal glycaemic control and variability in type 1 diabetes under routine clinical practice: A glucodensities-based post hoc analysis of the OneCare study
Diabetes, Obesity and Metabolism
·
20 Feb 2024
·
doi:10.1111/dom.15496
Author Correction: Reassessment of fluctuating dental asymmetry in Down syndrome
Scientific Reports
·
16 Jan 2024
·
doi:10.1038/s41598-024-51672-w
2021
Glucodensities: A new representation of glucose profiles using distributional data analysis
Statistical Methods in Medical Research
·
01 Jun 2021
·
doi: 10.1177/0962280221998064